
开发者 3 秒速决决策指标
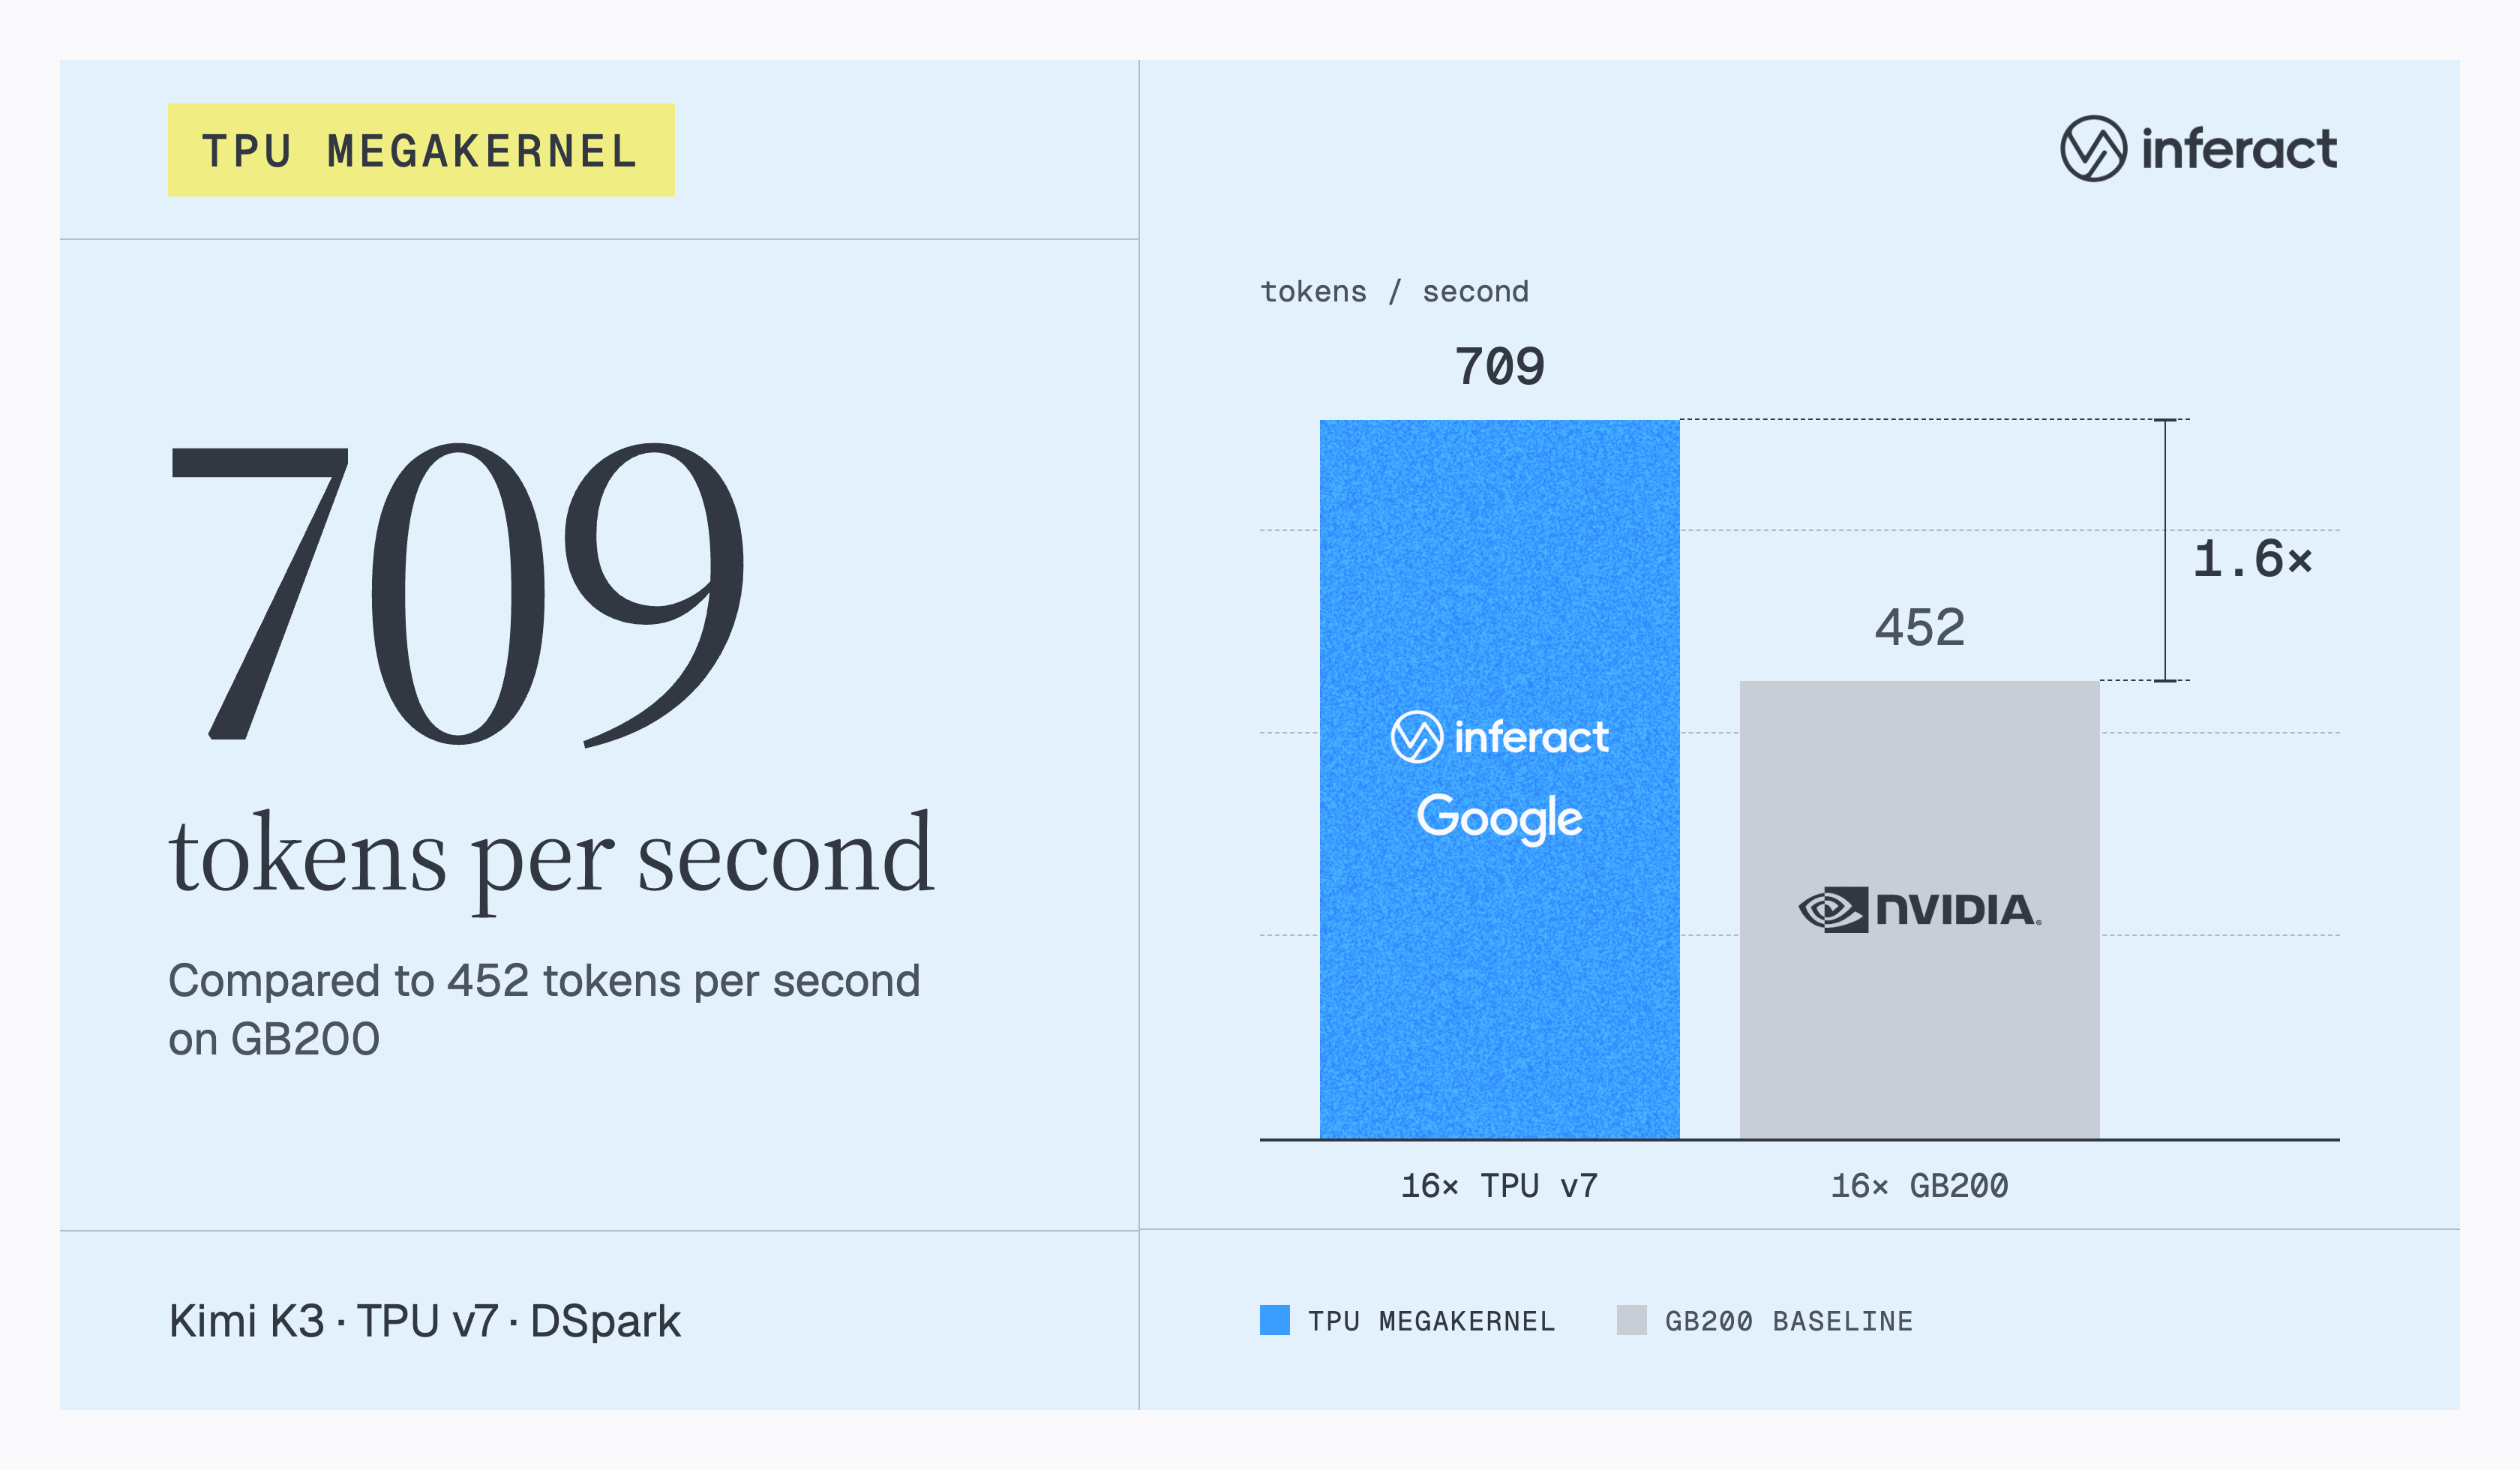
Inferact(vLLM 核心团队衍生公司)于 2026-09-23 发布并开源面向 TPU v7 的推理巨内核仓库 inferact/tpu-megakernels。官方博客显示,在 DSpark 推测解码(acceptance length=6)的低并发设定下,Kimi K3 在 16×TPU v7 Ironwood 上达到 709 tok/s,对照 16×GB200 基线 452 tok/s;关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×。整套 Kimi K3 的 92 层 MoE 解码被收敛进单一 Pallas 内核。
核心要点速览 (Key Takeaways)
- ✓官方数字(Inferact 自测,非第三方复现):Kimi K3 + DSpark 在 16×TPU v7 上 709 tok/s,对照 16×GB200 452 tok/s(acceptance length=6)
- ✓关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×;Qwen 3.8 27B 在 4×TPU v7 上报 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)
- ✓架构要点:92 层 MoE 装进 单一 Pallas 巨核,跨层 weight prefetch,吃满 TPU 大容量 VMEM
- ✓开源仓库:Inferact/tpu-megakernels(Apache-2.0),配套深度文:700 TPS on Kimi K3
阅读完核心要点?进一步了解模型实力与实际开销
7 大权威镜像天梯跑分与 29+ 款主流编程套餐横向比价测算
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Agent 与交互式对话把推理压到低并发、低 batch——此时 HBM→片上搬运与算子启动开销,往往比峰值算力更致命。GPU 上 megakernel 难做(跨数百 SM 同步成本高),而 Google TPU v7 仅有极少计算核心、却有大块程序可控的 VMEM,更适合把整条 decode 路径焊进一个内核。Inferact(vLLM 共创者 Woosuk Kwon 等所在团队)据此发布并开源 tpu-megakernels。
架构亮点与底层机制
官方深文 700 TPS on Kimi K3 说明:Kimi K3 全部 92 层 MoE 跑在单一 Pallas 巨核内;跨层 weight prefetch,使下一层权重搬运与当前层计算重叠。设计围绕 TPU 的 VMEM 与显式异步流水,逼近带宽上限,而非堆砌碎片小算子。
权威 Benchmark 与实测跑分对比
数字均来自 Inferact 自测,非独立第三方复现,且偏低并发场景。DSpark 推测解码(acceptance length=6)下:Kimi K3 在 16×TPU v7 报 709 tok/s,对照 16×GB200 的 452 tok/s;关闭推测解码时 batch 1–8 约为 GB200 基线 1.4–2×。同文还给出 Qwen 3.8 27B:4×TPU v7 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)。文中未公布成本/功耗与高并发曲线。
开发者实战落地与开箱指南
- 阅读 Inferact 博客 理解 VMEM/prefetch 假设;2. Clone Inferact/tpu-megakernels(Apache-2.0)在 TPU v7 环境复现;3. 与 vLLM GPU 侧 Kimi K3 优化文 Road to 2.8× 对照选型;4. 生产前自行压测目标 concurrency,勿直接外推官网低并发峰值。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察