AI 编程实时动态与要闻

Simon Willison 联合 Prime Radiant 开源 External Sandbox:编码 Agent 留在 Mac 上运行,命令和代码改到 WebAssembly(v86)、QEMU 或 Apple Container 的 Linux 沙箱里执行,已接 Claude Code、Codex 和 Pi

Simon Willison 11 月 17 日在 X 介绍「外部沙箱」(external sandbox)模式:Claude Code、Codex、Pi 等编码 Agent 本身在 Mac 上运行,但它们执行的命令和文件操作被转发到隔离的 Linux 环境。他与 Superpowers 背后的 Prime Radiant 一起把原型开源在 GitHub(Apache 2.0):一套统一的 HTTP/WebSocket 协议和 pytest 一致性测试,加上 v86(WebAssembly)、Apple Container、Quicksand QEMU 三种后端,每种都可选 HTTP/HTTPS 白名单代理和凭证替换。帖子获约 700 赞、190 多条回复。

核心要点速览

  • 模式要点:Agent 的 harness 留在宿主机,只有它执行的命令和文件读写进沙箱;Willison 称这样 Agent 自己的凭证不进沙箱,沙箱可以完全断网,Agent 仍能和模型通信
  • 三种后端:external-sandbox-v86(Node.js,v86/WebAssembly 跑 Linux,npx 一行启动,约 36 MB)、external-sandbox-container(Apple Container)、external-sandbox-quicksand(QEMU)
  • 接入方式:Claude Code 通过 shell prefix 把整条命令发到 /exec/ws;Codex 通过 /codex 端点把进程和文件系统操作(含 apply_patch)转到沙箱,按 Codex CLI 0.164.0 测试;Pi 有单独扩展发布在 npm
  • 安全控制:可选 HTTP/HTTPS 主机白名单代理,加凭证替换机制,让沙箱内代码调用需鉴权的 API 而不接触真实密钥
  • 状态:原型,Apache 2.0;Codex 的 exec-server 协议仍是实验性,新版本 CLI 需自行验证兼容性
阅读全文

Google GTIG 最新 AI 威胁报告:首次发现攻击者用多 Agent 框架 exploit_agent 全自动「读补丁→写漏洞利用→执行」,无人参与;另有攻击者篡改 .claude/settings.json 让 Claude Code 启动即下载后门

Google Threat Intelligence Group(GTIG)11 月 16 日在官方博客和 X 发布最新 AI Threat Tracker。报告称上季度首次发现攻击者用 LLM 框架在无人参与的情况下全自动完成漏洞发现与利用:在一台暴露的测试服务器上找到多 Agent 框架 exploit_agent,接入多个前沿和本地模型,持续对比热门 Web 软件补丁前后代码,推断漏洞、起草并自动执行利用。报告还披露疑似 MIDNIGHT NEPTUNE 团伙篡改内部仓库的 .claude/settings.json,使用户启动 Claude Code 时自动下载 SOMBERMEME 后门。

核心要点速览

  • exploit_agent:多 Agent 漏洞研究与武器化框架,接入多个前沿和本地 LLM,对比补丁前后代码→识别漏洞→起草 exploit→自动执行,全程无人参与
  • 同一服务器上还有窃取的受害者数据,以及内部侦察、暴力破解、安装 webshell、清除其他攻击者 webshell 的脚本;受害者遥测显示目标为法国媒体、娱乐和教育网站
  • 配置文件含俄语注释;GTIG 未归因具体团伙,未公布 CVE、受害者数量或成功率
  • 疑似 MIDNIGHT NEPTUNE 篡改 .claude/settings.json,让 Claude Code 启动时下载 SOMBERMEME 后门,并用以 Microsoft Copilot 命名的 GitHub PAT 掩护横向移动
  • 报告还点名 ARTEX、CAIRN、CyberStrikeAI、PentAGI 等多 Agent 攻击框架,以及盗用云端 LLM 配额的 LLMJacking
阅读全文

Databricks 发布公开「AI Index」:1 万+企业数据显示开源权重模型占企业 token 从 7.3% 升至 30.9%,Opus 5.5 六周拿下 37.9% 专有模型份额,编码测试中 GPT-6 Luna 与 Opus 5.5 同为 89.1% 但单任务成本差约 32 倍

Databricks 11 月 16 日在官方博客和 X 发布 Databricks AI Index,汇总 1 万多家企业经 Unity Gateway 的匿名用量,以及基于内部真实 PR、隐藏测试的编码 Agent 评测,每周更新。数据显示开源权重模型占企业 token 从 7 月 7.3% 升到 11 月 30.9%,只用单一模型供应商的企业从约 64% 降到 28%;Claude Opus 5.5 六周内从 7.2% 升至 37.9% 专有模型 token。编码评测中 GPT-6 Luna 与 Opus 5.5 成功率同为 89.1%,单任务成本分别约 0.05 和 1.62 美元。

Databricks 发布公开「AI Index」:1 万+企业数据显示开源权重模型占企业 token 从 7.3% 升至 30.9%,Opus 5.5 六周拿下 37.9% 专有模型份额,编码测试中 GPT-6 Luna 与 Opus 5.5 同为 89.1% 但单任务成本差约 32 倍

核心要点速览

  • 数据来源:1 万多家企业经 Unity Gateway 的匿名用量 + 基于 Databricks 私有代码库真实 PR 和隐藏测试的编码 Agent 评测,当前数据覆盖 9 月 21 日至 11 月 7 日,每周更新
  • 开源权重模型 token 份额 7.3%(7 月)→ 30.9%(11 月);开源模型中 GLM 5.3 Flash 33.3%、DeepSeek V4.1 Flash 28.0%、GLM 5.3 21.6%(11 月 2 日当周)
  • Opus 5.5 六周内从 7.2% 升至 37.9% 专有模型 token,Anthropic 整体份额从 57.6% 升至 68.8%;Fable 5.1 份额从 5.5% 降到 0.6%
  • 编码评测:Fable 5.1 成功率 96.0%(7.47 美元/任务)居首,Muse Wonder 94.9%(1.53 美元);DeepSeek V4.1 与 GLM 5.3 并列第三 93.1%
  • token 单价不等于成本:Gemini 3.8 Flash 平均 140 轮/任务,单任务约 11.97 美元;用户周支出中位数 2.49 美元,P99 为 699.74 美元
阅读全文

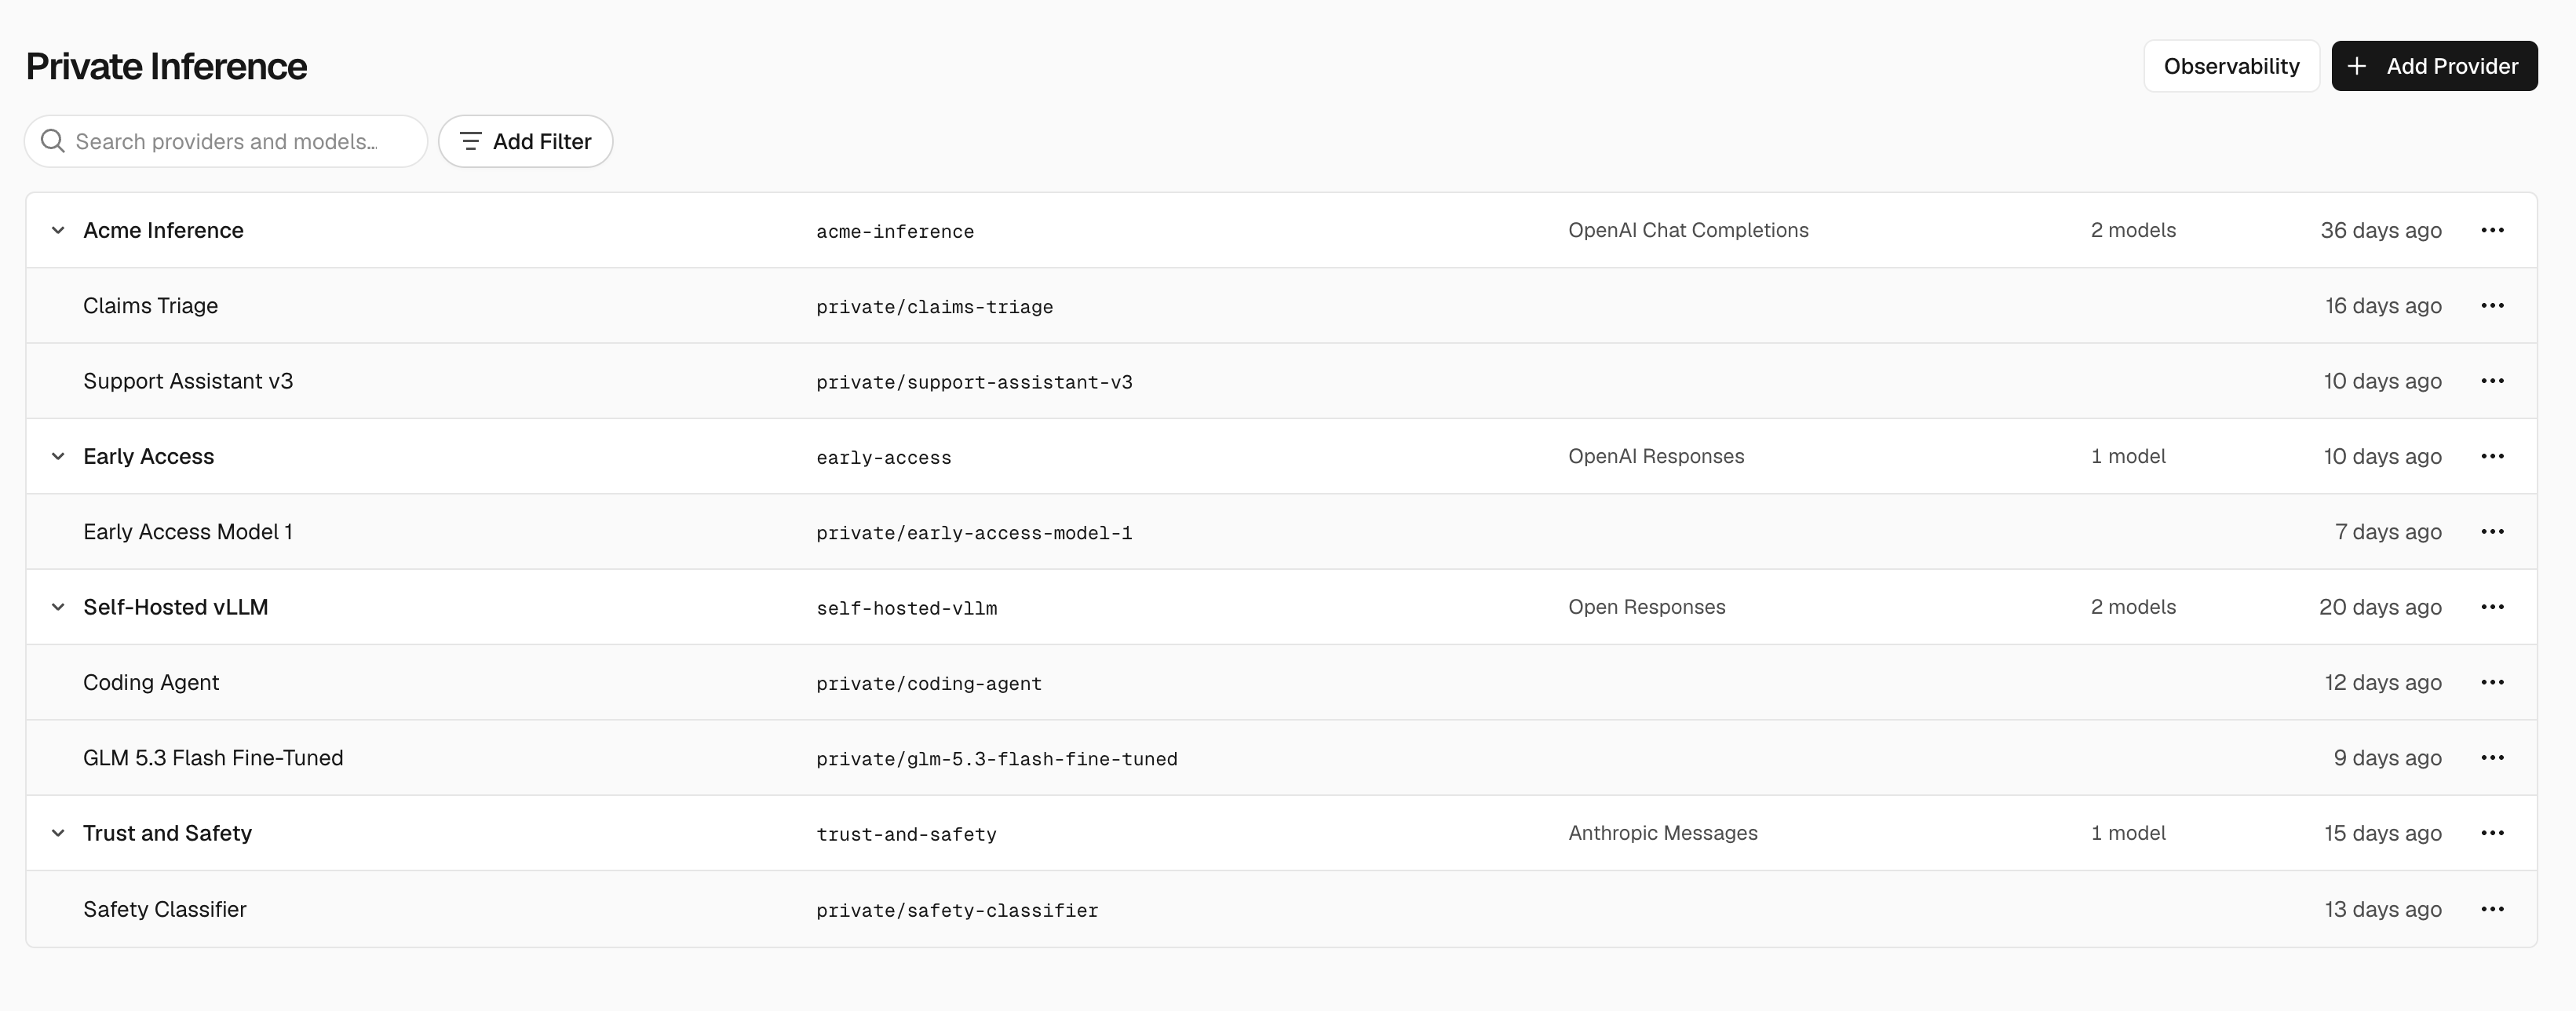
Vercel AI Gateway 上线 Private Inference:自托管、微调和预发布模型用 private/ ID 接入,与目录模型共用 API、鉴权和日志

Vercel 在 X 和官方 changelog 宣布 AI Gateway 支持 Private Inference:企业可把自己的模型端点注册为私有提供商,用 private/<slug> 模型 ID 通过 Chat Completions、Responses 或 Messages 调用,网关自动转换请求格式。私有模型只对本团队可见,凭证加密存储,可按提供商开启零数据保留,并能在 Claude Code、Codex、Cursor 等编程 Agent 中使用,端点故障时可回退到目录模型。

Vercel AI Gateway 上线 Private Inference:自托管、微调和预发布模型用 private/ ID 接入,与目录模型共用 API、鉴权和日志

核心要点速览

  • 把微调、自托管或预发布模型端点注册为私有提供商,用 private/<slug> ID 调用,切换模型只改 model ID
  • 支持 Chat Completions、Responses、Messages 三种 API,网关把请求翻译成端点自身格式
  • 私有模型只对本 Vercel 团队可见、不进公开目录,凭证加密存储,可按提供商开启零数据保留
  • 可在 Claude Code、Codex、Cursor 等接入 AI Gateway 的编程 Agent 里使用;日志、trace drain 和报表与目录模型合并展示
  • 可选端点故障时回退到目录模型;Vercel CLI 65.16.0+ 提供 private-inference providers/models create 命令
阅读全文
AD赞助内容

Scale AI 与 CAIS 的 Remote Labor Index 榜单:Claude Fable 5.2 以 41.25% 自动化率登顶,约为第二名 Opus 5.5(21.25%)的两倍

Scale AI 官方 Remote Labor Index(RLI)排行榜显示,Anthropic 的 Claude Fable 5.2 自动化率为 41.25%,排名第一;第二名 Opus 5.5 为 21.25%,GPT 6 Astra 为 20.83%,Gemini Argon 4 为 17.08%。RLI 由 Center for AI Safety 和 Scale AI 推出,用真实付费的远程自由职业项目考察 Agent 能否端到端交付合格成果。该结果在 X 上被 @kimmonismus 转述后引发热议。

核心要点速览

  • Scale AI 官方 RLI 榜单:Fable 5.2 41.25% 第一,Opus 5.5 21.25%,GPT 6 Astra 20.83%,Fable 5.1 17.92%,Gemini Argon 4 17.08%
  • RLI 的分数是“自动化率”:Agent 交付的成果达到客户可接受标准的项目占比,官方说明该指标没有置信区间
  • 官方评分使用 230 个项目的私有测试集;项目来自游戏开发、产品设计、建筑、数据分析、视频动画等领域,总计超过 6,000 小时、价值超过 14 万美元的真实工作
  • RLI 官网称近 3 个月自动化率约每 3.3 个月翻一倍;榜单上早期 Agent(如 Manus 1.0、gpt-5.2)只有约 2.5%
  • 41.25% 也意味着多数项目仍未达标,交付前的人工审核依然必要
阅读全文

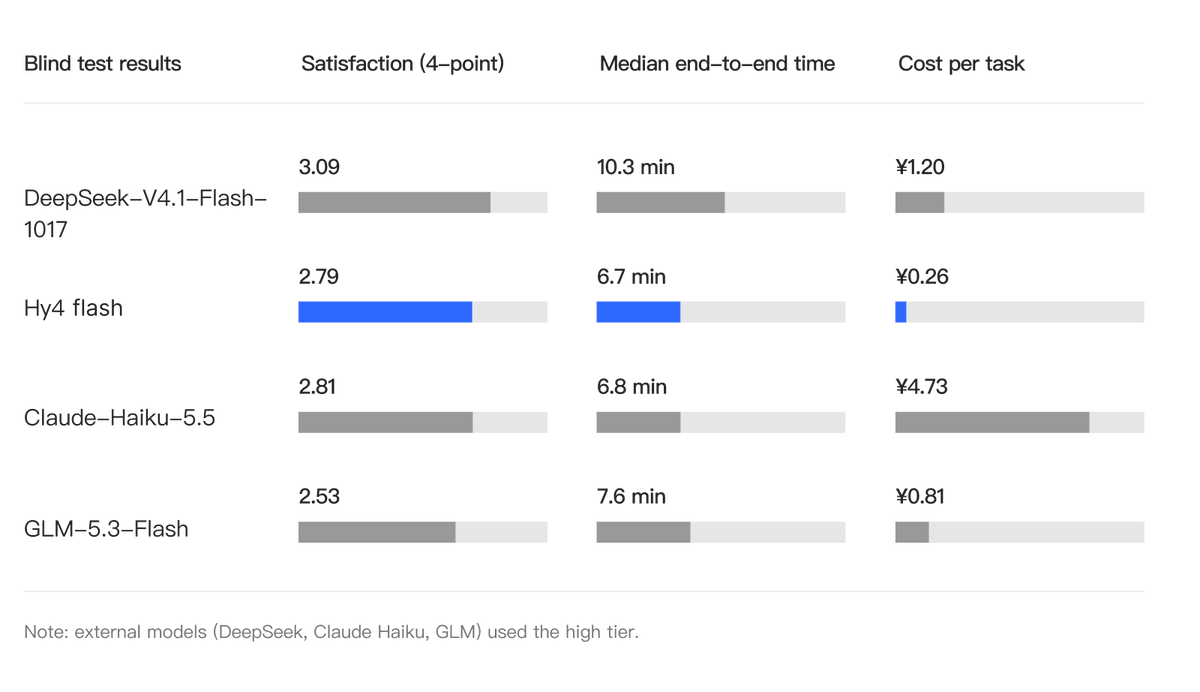
腾讯混元发布 Hy4 flash:主打日常办公的低价模型,API 输入 $0.070 / 输出 $0.281 每百万 token,官方盲测称接近 Claude Haiku 5.5

腾讯混元官方账号 @TencentHunyuan 于 2026-11-16 发布 Hy4 flash,称其为“日常生产力最便宜的模型”。官方人工盲测中,Hy4 flash 满意度 2.79(4 分制),与 Claude Haiku 5.5(high)的 2.81 基本持平,单任务成本 ¥0.26 对 ¥4.73,约便宜 18 倍;DeepSeek-V4.1-Flash-1017 满意度 3.09 更高,但单任务成本 ¥1.20。API 定价为缓存命中 $0.003、输入 $0.070、输出 $0.281(每百万 token)。

腾讯混元发布 Hy4 flash:主打日常办公的低价模型,API 输入 $0.070 / 输出 $0.281 每百万 token,官方盲测称接近 Claude Haiku 5.5

核心要点速览

  • 腾讯混元在 Hy4 正式版(11 月 4 日)之后推出更便宜的 Hy4 flash,定位日常办公和高频任务
  • API 定价:缓存命中 $0.003 / 输入 $0.070 / 输出 $0.281 每百万 token
  • 官方盲测(4 分制):Hy4 flash 2.79、Claude Haiku 5.5 2.81、DeepSeek-V4.1-Flash-1017 3.09、GLM-5.3-Flash 2.53;外部模型均用 high 档
  • 单任务成本:Hy4 flash ¥0.26,Claude Haiku 5.5 ¥4.73,DeepSeek-V4.1-Flash-1017 ¥1.20;中位端到端耗时 6.7 分钟,与 Haiku 的 6.8 分钟接近
  • 内部 WorkIndex:Hy4 flash 42.1,高于 Hy4 preview 的 39.7,低于 Hy4 的 51.4,单任务成本比 Hy4 便宜约 24.5 倍(均为腾讯内部数据)
阅读全文
关联模型 / 智能体 / 厂商:
A
Anthropiccode.claude.com·
👀63
🔥85

Claude Code 推出实验性 Code Mode:Claude 改为写一段 JavaScript 一次性批量调用工具,v2.1.323 起可手动开启

Anthropic 在 Claude Code v2.1.323(GitHub 发布于 11 月 12 日)的更新日志里加入 Code Mode,并上线官方文档。开启后,Claude 不再逐个请求 Bash、Read、Edit 等工具,而是写一段 JavaScript,在会话里并行跑命令、把上一步结果传给下一步、只把需要的输出返回给模型。该功能默认关闭,需设置环境变量 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1;仅支持终端里的交互式 claude 会话、原生安装版,以及 Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.2 等模型。11 月 13 日的 v2.1.325 又修了一批 Code Mode 问题。

核心要点速览

  • 开启方式:设置 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1(shell 或 ~/.claude/settings.json),首次需确认;项目内 settings 里的该变量会被忽略,克隆的仓库无法替你开启(官方文档)
  • 工作方式:Claude 写 JavaScript 调用工具,一段代码可并行执行命令、串联结果;界面里仍显示工具调用,按 Ctrl+O 可看代码
  • 限制:只支持终端交互式会话;不支持 -p、Agent SDK、VS Code 面板、桌面端、云端会话,也不能经网关、Bedrock、Vertex/Agent Platform、Foundry 使用;HIPAA 与零数据保留组织不可用
  • 权限:每个工具调用仍走 deny/ask 规则和 PreToolUse hook;auto 模式下分类器审的是整段代码而非单个调用,前台代码最长 10 分钟、后台最长 2 小时
  • 企业管理员可在 managed settings 里把该变量设为 0 全组织禁用;v2.1.325 已修复 worktree、权限对话框输入丢失、恢复会话自动开工等 Code Mode 问题(更新日志)
阅读全文

GitHub Copilot 全面上线 Gemini 4 Hydrogen(VS Code、CLI、编码 Agent 等全平台,按厂商标价计费);同日宣布 12 月 14 日下线 Claude Fable 5、Gemini 3.8 Flash、Grok 4.6、Kimi K3 等 6 个模型

GitHub 于 11 月 13 日在官方 Changelog 宣布:Google 最新的 Flash 级模型 Gemini 4 Hydrogen 已在 GitHub Copilot 正式可用(GA),面向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户,可在 VS Code、Visual Studio、Copilot CLI、Copilot 编码 Agent、Copilot app、github.com、移动端、JetBrains、Xcode、Eclipse 和 Copilot SDK 的模型选择器中使用,逐步放量,按用量计费、价格为厂商标价。GitHub 称它面向快速高效的 Agent 编码、工具调用和多步工作流,指令遵循比 Gemini 3.8 Flash 更好。同一天 GitHub 还发布弃用通知:2026 年 12 月 14 日起,Copilot 全部体验将下线 Claude Fable 5、Claude Haiku 4.5、Gemini 3.8 Flash、Gemini 4 Argon、Grok 4.6 和 Kimi K3,并给出替代模型。

GitHub Copilot 全面上线 Gemini 4 Hydrogen(VS Code、CLI、编码 Agent 等全平台,按厂商标价计费);同日宣布 12 月 14 日下线 Claude Fable 5、Gemini 3.8 Flash、Grok 4.6、Kimi K3 等 6 个模型

核心要点速览

  • Gemini 4 Hydrogen 在 GitHub Copilot 正式可用,面向 Pro、Pro+、Max、Business、Enterprise 用户,逐步放量(GitHub Changelog)
  • 覆盖面很广:VS Code、Visual Studio、Copilot CLI、Copilot 编码 Agent、Copilot app、github.com、iOS/Android、JetBrains、Xcode、Eclipse 和 Copilot SDK 都能在模型选择器里选到
  • 计费:按用量计费、价格为厂商标价;企业和商业版默认自动启用新模型,管理员可在 Copilot 设置的模型策略里关闭
  • 12 月 14 日下线 6 个模型及官方建议替代:Claude Fable 5→Fable 5.2,Claude Haiku 4.5→Haiku 5.5,Gemini 3.8 Flash→Gemini 4 Hydrogen,Gemini 4 Argon→Gemini 4 Carbon,Grok 4.6→Grok 4.7,Kimi K3→待公布(弃用通知)
  • 例外:年付的 Copilot 个人订阅用户仍可继续使用 Claude Haiku 4.5
阅读全文

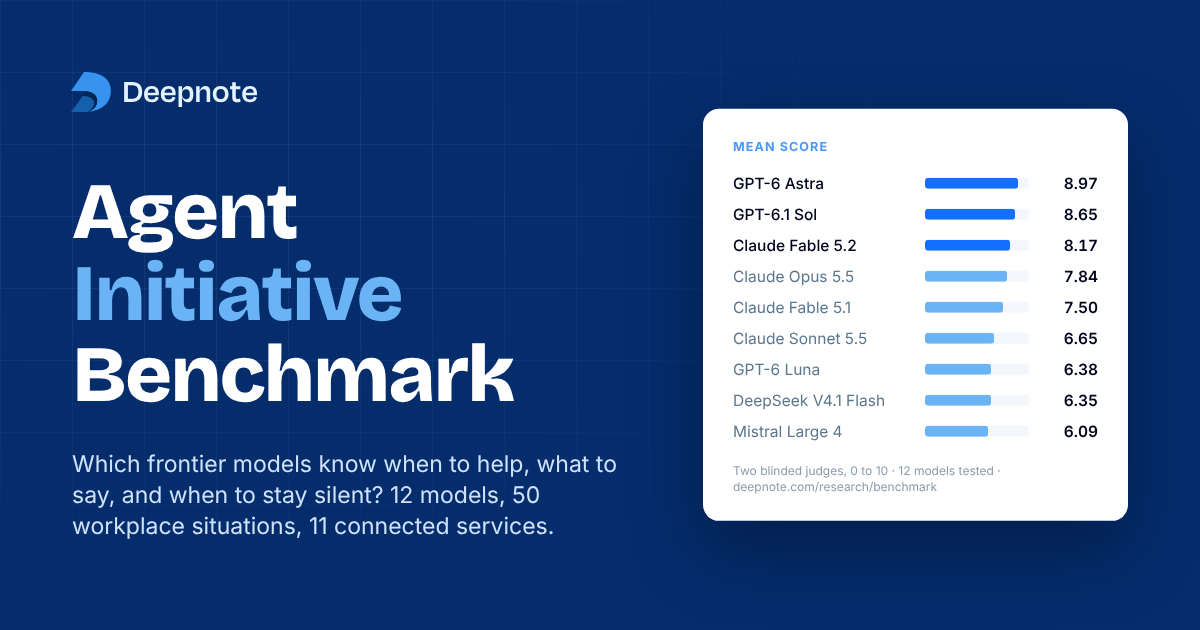
Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二

数据笔记本公司 Deepnote 开源 Agent Initiative Benchmark v1.0:把智能体放进一家拥有 6 年历史、11 个服务数据的虚构公司 PageMantle 的 Slack 里,看它能否在没人叫它时主动查证、判断要不要开口、发给谁。50 个场景测 12 个模型,GPT-6 Astra 8.97 分第一,GPT-6.1 Sol 8.65 分第二,Claude Fable 5.2 8.17 分第三。

Deepnote 发布 Agent Initiative Benchmark:测 12 个前沿模型做「主动型智能体」,GPT-6 Astra 以 8.97 分居首,GPT-6.1 Sol 每任务仅 0.11 美元排第二

核心要点速览

  • 排名前三:GPT-6 Astra 8.97、GPT-6.1 Sol 8.65、Claude Fable 5.2 8.17;Gemini 4 Argon 5.60、Grok 4.7 4.51 垫底(官方结果页)
  • 最贵不等于最好:Sol 每任务 0.11 美元,Fable 5.2 为 1.87 美元;GPT-6 Luna(0.007 美元)与 Claude Fable 5.1(3.02 美元)价差约 430 倍,分数只差 1.1 分
  • 模型擅长帮忙、不擅长闭嘴:该开口时约 9/10 会发消息,该沉默时只有约 6/10 忍住;多说一次的成本约是沉默的 1.8 倍
  • 工具调用最多的两个模型得分最低:Gemini 4 Argon 平均 35 次、Grok 4.7 平均 36 次,约一半需要帮忙的任务没给出答案
  • 代码与任务 Apache 2.0、PageMantle 数据集 CC BY 4.0,已放在 GitHub 与 Hugging Face
阅读全文

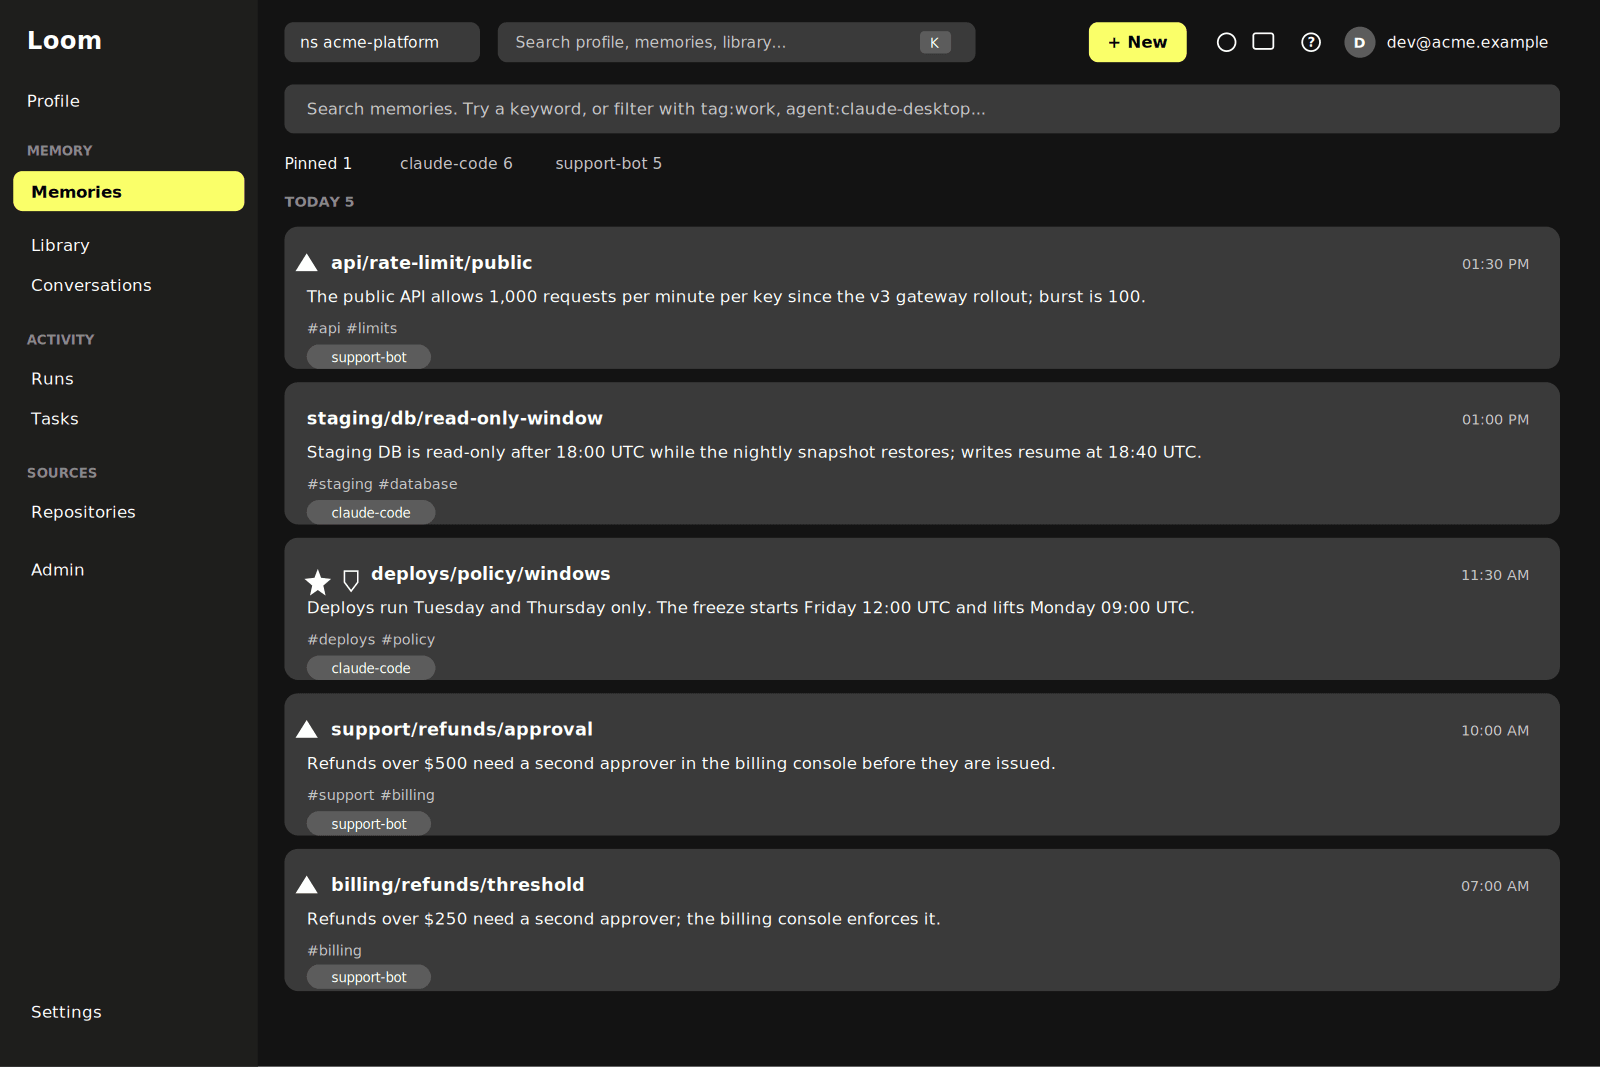
ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

ClickHouse 发布开源(Apache-2.0)的智能体记忆系统 Loom,把记忆、代码索引和运行日志放进同一个 ClickHouse 库,记忆与代码关联,代码变动时标记可能过时的记忆。支持 MCP、HTTP API、Python/TS SDK,提供 Claude Code 和 Codex 插件。官方测试中代码问答平均分从 0.78 升到 0.84。

ClickHouse 开源 Loom:给编码智能体的共享记忆 + 实时代码索引,代码问答得分 0.78→0.84

核心要点速览

  • 代码问答(24 题×3 次)平均分 0.78→0.84,单题平均成本 $0.212→$0.17(官方口径,博客)
  • 找文件任务(36 题×10 次)准确率 91.4%→96.4%
  • LongMemEval-S 100 题:检索记忆 94% 对比塞入完整历史 90%,读取 token 少约 90%;完整 500 题 memory.ask 96.6%(官方口径)
  • 记忆与代码索引同库:函数改名会跟随,被重写则标记待复核,不自动改写
  • Apache-2.0 开源,需 ClickHouse 26.5+(推荐 26.8+),一行脚本用 Docker 启动
阅读全文
AD赞助内容

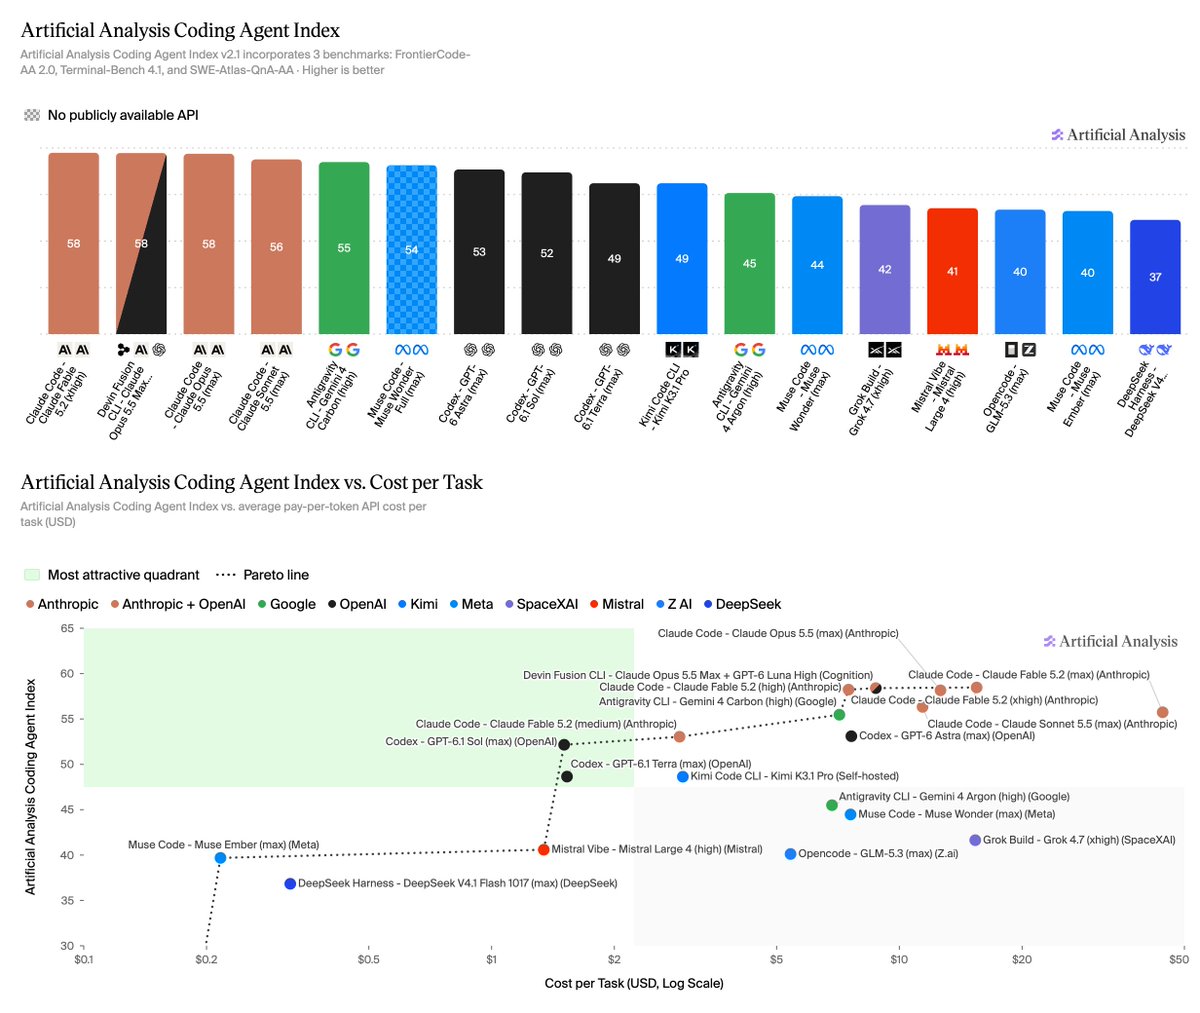
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。

Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

核心要点速览

  • v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
  • 并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
  • 23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
  • 成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
  • Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
阅读全文

Arena 分析 105 个编程模型:4 月的最强编程水平到 10 月只需不到 1/20 的价格,榜首分数增速是去年冬天的 3 倍,几乎每两天上榜一个新模型

Arena 统计了 Code Arena: WebDev 榜自 2025 年 12 月以来 44 期周榜的 105 个模型。结论:小米 MiMo-V2.6-Flash 已超过 4 月榜首 Claude Opus 4.7,价格不到其 1/20;5 月以来榜首分数每月涨约 41 分,是冬季的 3 倍;1 美元以下的 25 个前沿性价比模型里 19 个来自中国。

Arena 分析 105 个编程模型:4 月的最强编程水平到 10 月只需不到 1/20 的价格,榜首分数增速是去年冬天的 3 倍,几乎每两天上榜一个新模型

核心要点速览

  • 上榜节奏:去年冬天每月约 5 个新模型,7 至 9 月每月 12 至 14 个,10 月截至 23 日已有 11 个;OpenAI 上榜 12 个,Anthropic、阿里、Google 各 11 个
  • 榜首:4 月最强 Claude Opus 4.7 在当前榜上 1558 分,现榜首 Claude Opus 5.5 为 1807 分;新纪录平均只维持约 3 周,此前约 2 个月
  • 价格:每次回答 5 美分到 1 美元区间,现最佳模型对同价位 4 月最佳的估算胜率 65% 至 80%;Opus 5.5 (Max) 胜率约 81%,但每次回答约 10 美元
  • 排名波动:前 10 名实验室每周近半数换位,第 10 名与第 1 名的差距缩小 38%(282 分到 176 分)
  • 地区分化:1 美元以上 15 个前沿模型中 13 个来自美国;中国 21 个前沿模型中 17 个开源权重,美国 19 个中只有 2 个
阅读全文
关联模型 / 智能体 / 厂商:

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

11 月 12 日(UTC),获 Felicis 和英伟达投资的电脑操作智能体公司 Simular 发布 box:每个账号一台云端 Ubuntu 桌面,自带 Chrome 和常驻 shell,整体作为一个远程 MCP 服务器(mcp.box.simular.ai/mcp,Streamable HTTP,OAuth 登录)提供。claude.ai、ChatGPT、Gemini、Claude Code、Codex、Cursor、OpenCode、VS Code 等任何 MCP 客户端都能接入,不同助手可以在同一台机器上接力干活,共享登录状态和文件。用户可在网页或 iPhone 上实时观看,需要登录或付款确认时随时接管。桌面本身免费,模型调用消耗账号积分;空闲时休眠、约 1 秒唤醒,连续休眠 14 天会被删除。发布视频浏览量超过 81 万。官方称「生产环境最快的电脑操作」,但未公布跑分。

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

核心要点速览

  • 接入方式:一个远程 MCP 地址 mcp.box.simular.ai/mcp,OAuth 登录;Claude Code 一行 claude mcp add --transport http box ... 即可,CI 场景可用 cb_ 开头的个人密钥
  • 安装器 npx @simular-ai/[email protected] connect 会自动发现本机的 Claude Code、Codex、Cursor、OpenCode、Hermes、OpenClaw、VS Code 并写入配置,doctor/remove 可检查和撤销
  • 计费:桌面免费,模型调用用账号积分;空闲约 1 秒唤醒,连续休眠 14 天删除整台机器和文件
  • Secrets 功能:API 密钥加密存储,AI 只看到替身值,box 仅在发往指定域名的请求里替换成真实密钥
  • 官方发布视频约 81.5 万浏览;「最快电脑操作」为厂商口径,官方未公布 OSWorld 等跑分
阅读全文

X 热议:AI 博主 Chubby 称两个月来主力换成 Claude Code + Opus 5.5、「GPT 不错但差得远」,同时承认电脑操作仍是 GPT 的强项;150 多条回复聚焦「按任务分工」和当天的 Claude 登录故障

新加坡时间 11 月 13 日 18:12,约 15.9 万粉丝的 AI 博主、Superintel 主编 Chubby(@kimmonismus)发帖说,今年他一直在 Codex/GPT 和 Claude Code/Opus 之间来回切换,最近两个月主力是 Claude Code + Opus 5.5,称其为「迄今最高效、最聪明的模型」,GPT「不错,但差得远」。他也承认 Claude 的短板是电脑操作(computer use),这方面 GPT「无人能敌」;比起 ChatGPT 的 dots,他更想用 Claude Duet,但两者目前在欧洲都用不了。他在回复中补充,自己大约 80% 时间用 Claude。截至发稿,该帖约 2.9 万浏览、590 赞、152 条回复。发帖时正赶上 Anthropic 一次登录故障:UTC 09:58 至 11:58,claude.ai 和 Claude Code 无法登录。本文是个人观点与社区讨论,不是评测结论。

核心要点速览

  • 原帖约 2.9 万浏览、590 赞、152 回复、32 收藏;作者约 15.9 万粉丝,回复中称自己约 80% 时间用 Claude、20% 用 GPT
  • 核心观点:Opus 5.5 是「迄今最高效、最聪明」的模型,GPT 落后;但电脑操作是 GPT 的优势,OpenAI 官方称 GPT-6.1 Terra 在最高推理档下单任务成本约为 Opus 5.5 的 1/9(厂商口径)
  • Claude Duet 帮助中心写明:研究预览仅对美国 Pro、Max、Ultra 用户开放,需排队邀请,固定运行在 Opus 5.5 上
  • OpenAI 帮助中心截至发稿仍写明:Pro 版 dots 不面向欧洲经济区、瑞士和英国用户;原帖所说「欧洲似乎要开放」尚无官方公告
  • Claude 状态页:11 月 13 日 UTC 09:58 起 claude.ai 和 Claude Code 登录报错,11:05 部署修复,11:58 宣布恢复,前后约 2 小时
阅读全文

Anthropic 推出自托管版 Claude Managed Agents 私测:智能体框架、沙箱、凭据和会话记录都跑在企业自己的云或机房,模型请求可改走 Bedrock、Foundry 或自建网关

Anthropic 宣布自托管版 Claude Managed Agents 进入私测。以前企业只能全托管给 Anthropic,或只把沙箱放在自己这边;现在整套服务(API、智能体循环、会话记录存储、沙箱)都能部署在自己的云账号或本地机房,会话记录存进自家 PostgreSQL。模型请求可以发给 Anthropic,也可以走 Amazon Bedrock、Google 的 Claude 托管服务、Microsoft Foundry 或自建网关。开发者 API 与托管版一致。目前只对符合条件的组织开放,需要通过 Anthropic 客户团队申请。

Anthropic 推出自托管版 Claude Managed Agents 私测:智能体框架、沙箱、凭据和会话记录都跑在企业自己的云或机房,模型请求可改走 Bedrock、Foundry 或自建网关

核心要点速览

  • 三档部署:云端沙箱(全托管)→ 自托管沙箱 → 自托管 Managed Agents(服务 + 沙箱都在自己这边),官方文档用一张表列清楚
  • 组件清单:cma-server(API + 智能体循环)、PostgreSQL 16+、ant beta:worker 工作进程、管理 CLI cma-server-admin,另有 Docker Compose 和 Helm chart
  • 4 条安全原则:框架和沙箱分离、凭据不进沙箱、按主机白名单限网、每步操作经 OpenTelemetry 导出
  • 热度:@ClaudeDevs 首发帖写稿时约 1.1 万赞、79 万浏览;平台负责人 Katelyn Lesse 称这次还首次带上评测(evals)产品
  • 门槛:私测,只对符合条件的组织开放,要找 Anthropic 客户团队申请下载;官方未公布价格
阅读全文