Liquid AI 发布 d1.2 与 d1.2-ultra 全模态决策模型:新增音频输入和 5 类新任务,d1.2-ultra 以 75 分登顶 Artificial Analysis Decision Index v2.1
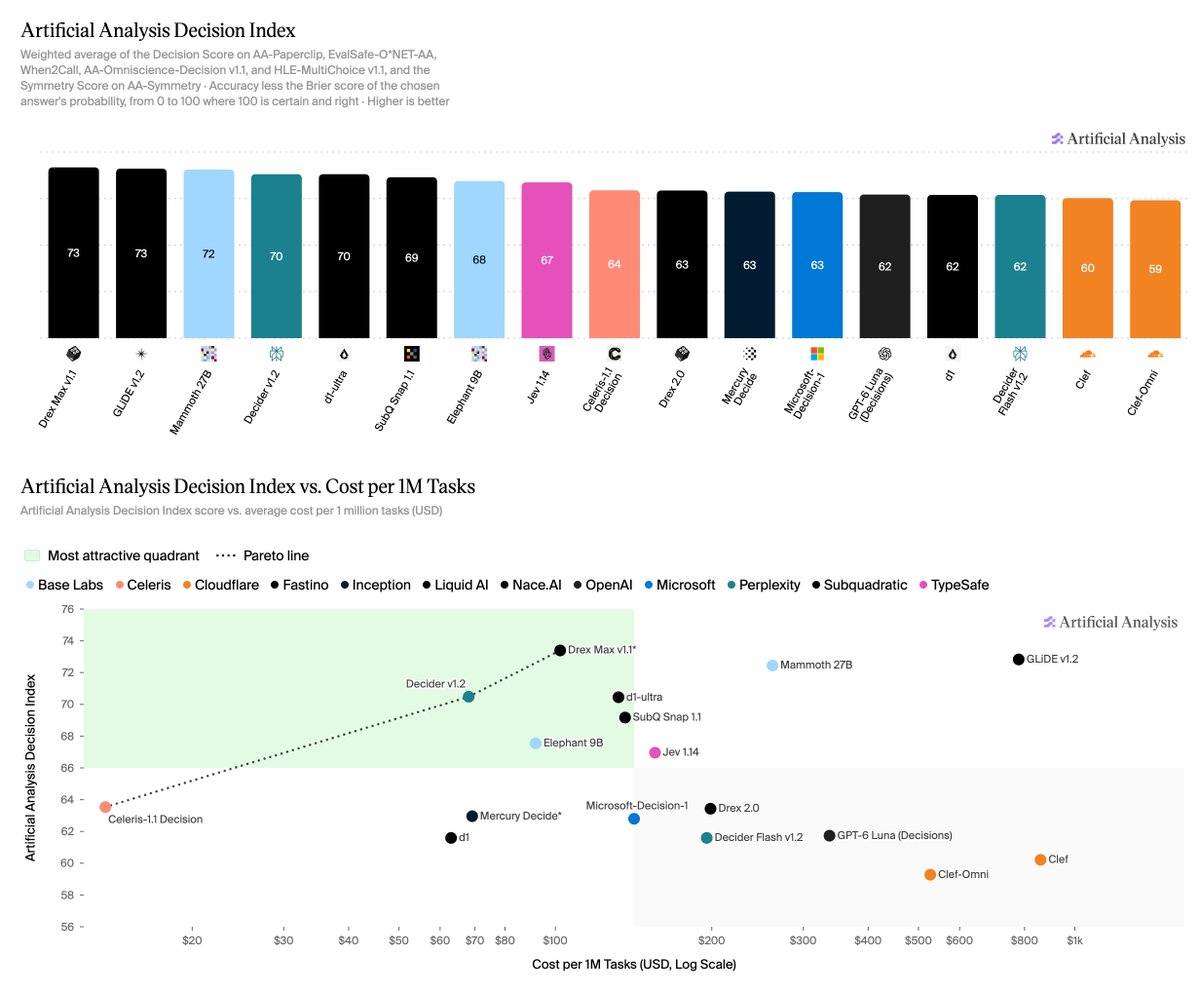
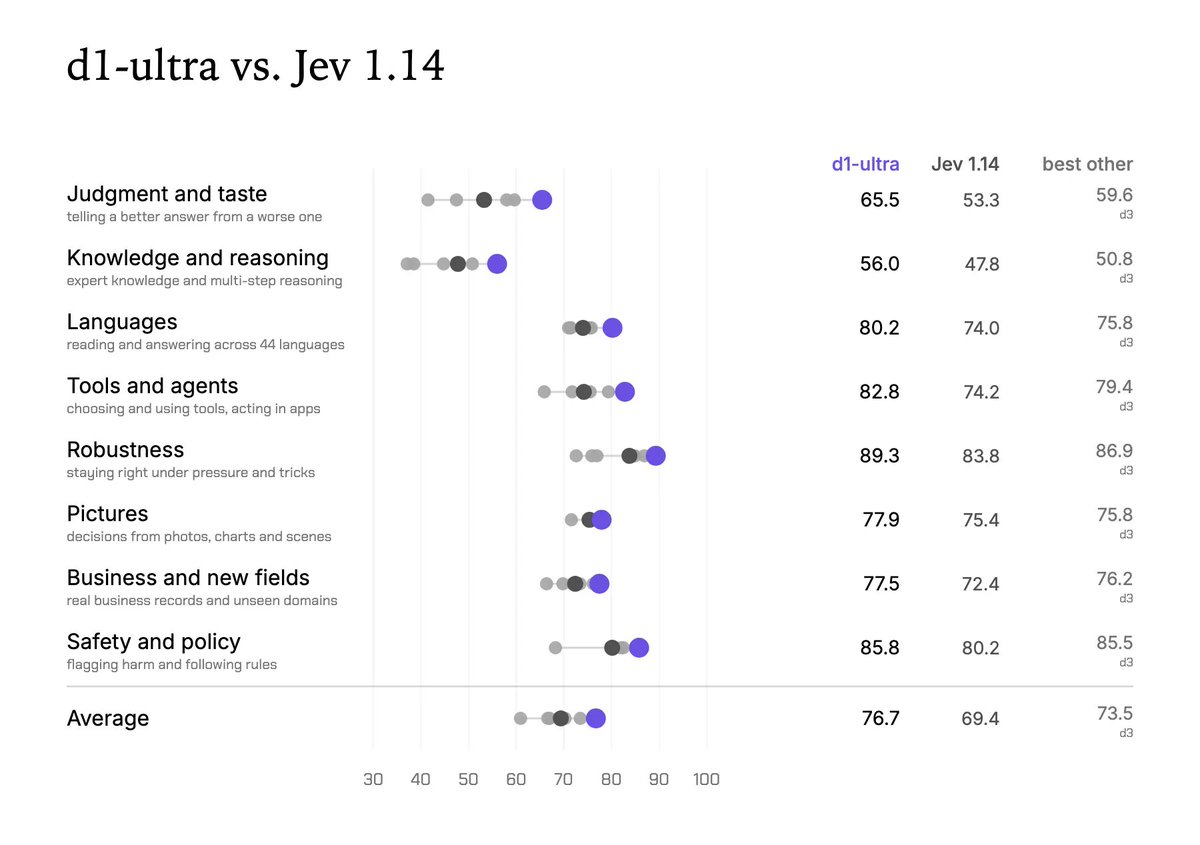
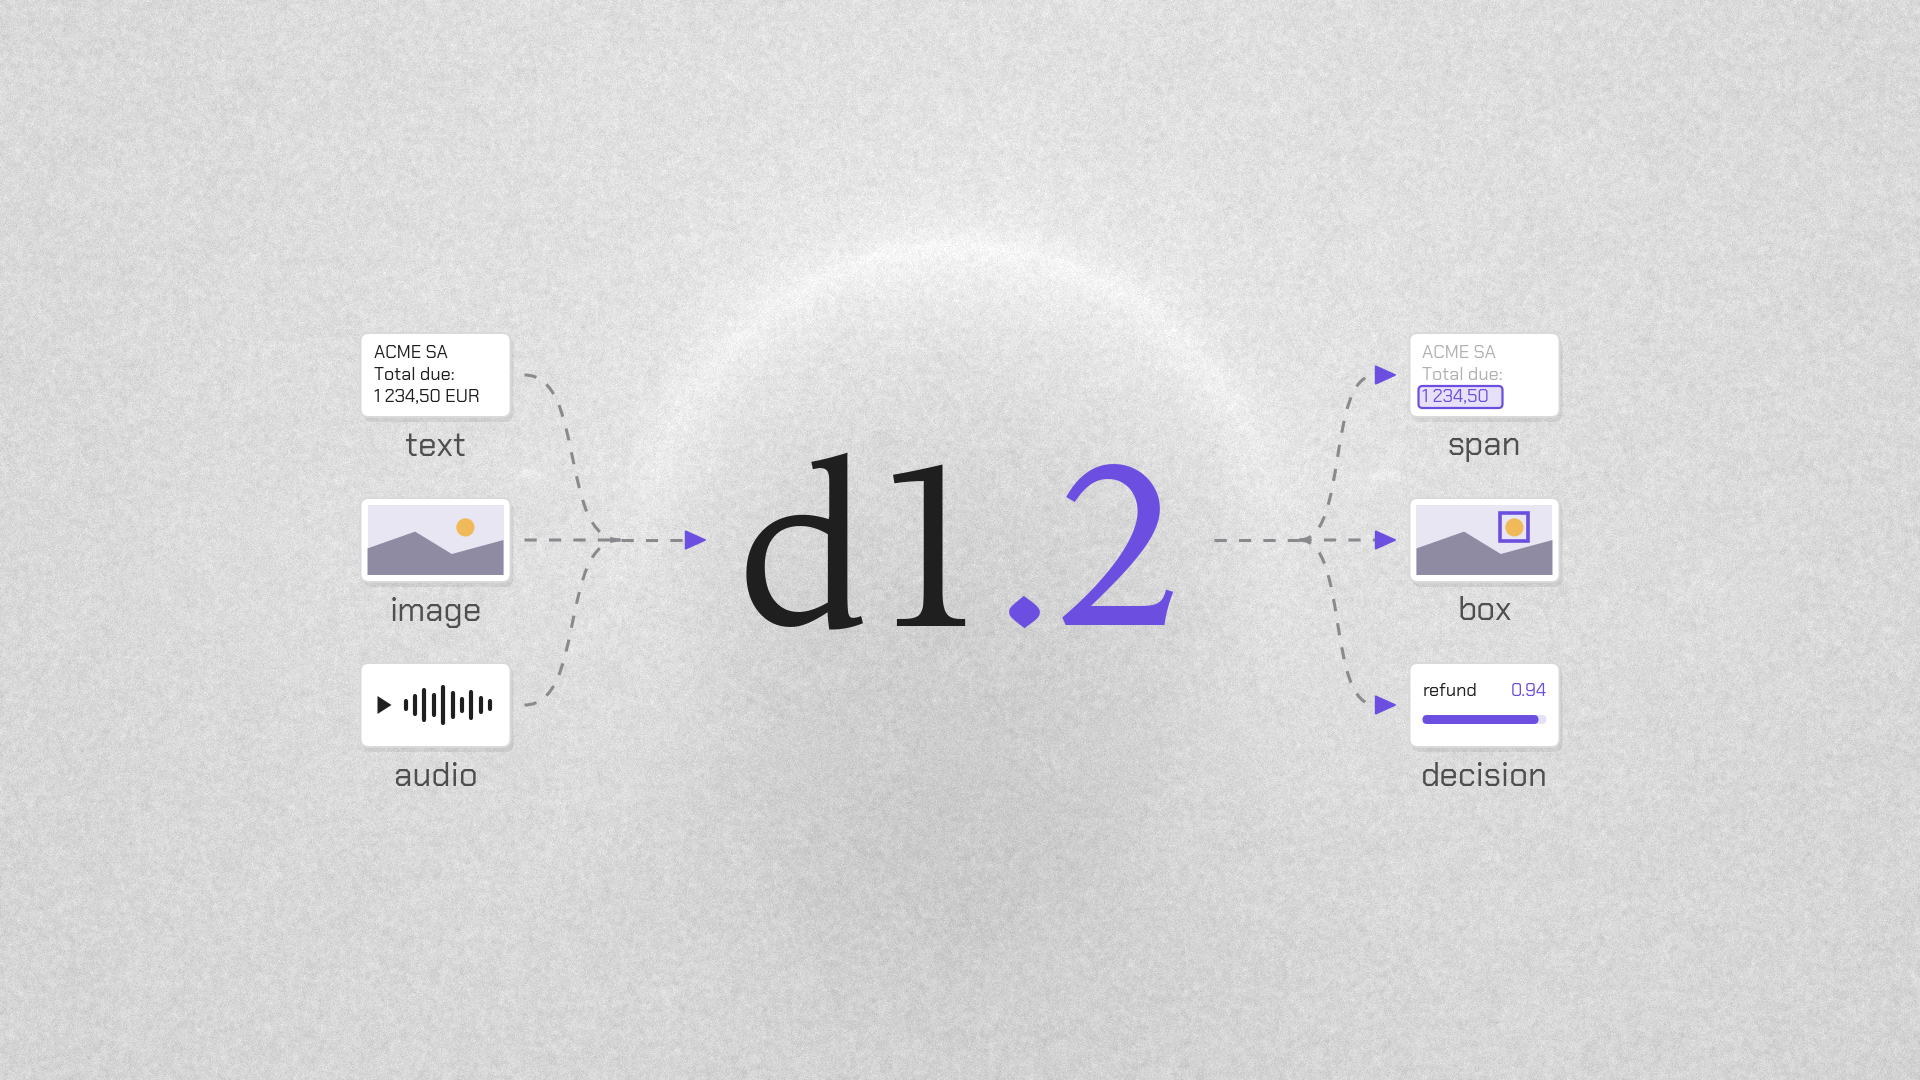
Liquid AI 发布决策模型新版本 d1.2 和 d1.2-ultra,可处理文本、图片和音频,新增读取数值、抽取片段、图中定位、数量估计和多选五类任务。d1.2-ultra 在 Artificial Analysis Decision Index v2.1 得 75 分,排名第一,比此前最佳决策模型高 2 分。两款模型已上线 Liquid API,只按输入计费:d1.2 每百万输入 token 0.02 美元,d1.2-ultra 0.042 美元,价格与上一代相同。
核心要点速览
- d1.2-ultra 在 Artificial Analysis Decision Index v2.1(6 项基准,同时考核答案概率)得 75 分,决策模型第一;Liquid 称同等花费下没有模型比 d1.2 分数更高
- 新增 5 类任务:读取文本/数字/日期值(找不到时回答「not found」)、抽取所有同类片段、图中框出单个或全部目标、带区间的数量估计、多选并给出各自概率
- 新增音频输入:既可以问关于录音的问题(如说的是哪种语言、背景是否有警笛),问题本身也可以是语音
- 只收输入费用,无输出 token 费:d1.2 每百万输入 token 0.02 美元,d1.2-ultra 0.042 美元;图片按每 32x32 像素块 1.5 token 计,1024x1024 约 1536 token
- Liquid 自测校准误差:d1.2-ultra 0.8、d1.2 1.2,对比 Jev 1.14 为 2.7、Perplexity Decider v1.3 为 3.7;新任务准确率来自 Liquid 内部测试集,非公开基准
关联模型 / 智能体 / 厂商: