AI 编程实时动态与要闻

斯坦福教授 Yejin Choi 与 Carlos Guestrin 创立 AI 实验室 Noeri,获 1.1 亿美元融资:做「企业自有、持续自我改进」的 AI 系统,Menlo 领投,NVIDIA、Snowflake、Cisco 参投

Noeri 在 X 和官方新闻稿宣布正式亮相并完成 1.1 亿美元融资,由 Menlo Ventures 领投,Madrona、Kindred、Wing、NEA 参投,Cisco Investments、NVIDIA、Snowflake 为战略投资方,估值未披露。Noeri 由斯坦福教授 Yejin Choi(前 NVIDIA 高级总监、nucleus sampling 共同提出者)和 Carlos Guestrin(XGBoost 共同作者、前 Apple AI 负责人)创立,两人任联合 CEO。产品从企业自身数据和工作流学习,持续优化指令、工具、模型分工乃至模型本身,每项改动附解释、经人审批。

核心要点速览

  • 融资 1.1 亿美元,Menlo Ventures 领投,Madrona、Kindred、Wing、NEA 参投,Cisco Investments、NVIDIA、Snowflake 战略投资,估值未披露
  • 联合 CEO:Yejin Choi(MacArthur 学者、前 NVIDIA 高级总监、top-p 采样的 nucleus sampling 共同提出者)与 Carlos Guestrin(XGBoost 共同作者、Turi 创始人、前 Apple 机器学习与 AI 负责人)
  • 产品定位:企业自有的「自我改进」AI,用应用日志、工具调用和验证结果持续优化 Agent 系统
  • 每项改动(指令、工具、哪个模型处理哪一步、必要时微调模型)都附解释并由人审批,类似代码评审
  • 据 Madrona,技术路线结合测试时训练、合成数据和自蒸馏;公司位于 Palo Alto,在苏黎世设有办公室
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 在 SC26 发布 Nemotron for Science:基于 Nemotron 3.5 Super VL 的开源科研 Agent 套件,含近 5 万题化学数据集 LitmusBench v0.2 和后训练配方

NVIDIA 在芝加哥 SC26 大会发布 Nemotron for Science,把开源模型 Nemotron 3.5 Super VL、科学评测、新的开放化学数据集 LitmusBench v0.2(近 5 万题)和后训练配方打包,帮助研究者构建能规划任务、跑模拟、检查结果的科研 Agent。官方称 Lila Sciences 后训练后量子点合成准确率达 61%,高于 GPT-6 Astra 的 54%,推理成本低 10–20 倍;模型和数据集已上架 Hugging Face。

NVIDIA 在 SC26 发布 Nemotron for Science:基于 Nemotron 3.5 Super VL 的开源科研 Agent 套件,含近 5 万题化学数据集 LitmusBench v0.2 和后训练配方

核心要点速览

  • Nemotron for Science 由 Nemotron 3.5 Super VL 开源模型、科学评测、LitmusBench v0.2 数据集和后训练配方组成
  • LitmusBench v0.2 是近 5 万题的开放化学推理数据集,基于分子性质和药物发现实验数据,可用于评测和后训练
  • 官方案例:Lila Sciences 量子点合成准确率后训练后达 61%(GPT-6 Astra 为 54%),推理成本低 10–20 倍;Terray 在 RxnScribe 上恢复约 76% 的标注反应
  • KTH 在单台 DGX Spark 上用 Nemotron Agent 一夜修复 81% 的 GROMACS 测试用例;Argonne、Jülich、RIKEN 已接入
  • 模型和数据集已在 Hugging Face 上线,Nemotron 3.5 Super VL 可在 128GB DGX Spark 本地运行
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Super VL🌐 NVIDIA

X 热议:马斯克称英伟达很多关键供应链协议只是和黄仁勋「握手成交」、没有书面合同,黄仁勋离开后部分会丢;转引 Dylan Patel「谷歌正向整条供应链求产能」片段,获 5.7 万赞、约 382 万浏览

新加坡时间 11 月 14 日 22:37,马斯克(@elonmusk)转引一段 SemiAnalysis 创始人 Dylan Patel 的访谈剪辑发帖:「黄仁勋把英伟达的供应链做得极其出色,但很多协议只是和黄仁勋握手达成的,并没有书面合同。没有了黄仁勋,至少有一部分关键协议会丢掉。」被转引的剪辑由 @CEOinterview 账号发布,Patel 在其中称黄仁勋曾亲自说服一些营收只有几亿美元、但掌握关键零部件的小供应商,把产能卖给英伟达;如今他离开,「谷歌正在向整条供应链求更多产能」。马斯克这条帖子约 382 万浏览、56,967 赞、5,374 转发、2,280 条回复。本文整理的是个人观点和社区讨论:英伟达未公开过这类协议的形式,「握手协议」和「谷歌求产能」均未经独立核实。

核心要点速览

  • 马斯克原帖:「很多协议只是和黄仁勋握手达成,并没有书面合同;没有黄仁勋,至少一部分关键协议会丢掉」,约 56,967 赞、5,374 转发、2,280 条回复、约 382 万浏览(原帖)
  • 被转引的是 @CEOinterview 发布的 Dylan Patel 访谈剪辑(约 91 秒,约 2,995 赞、约 310 万浏览):黄仁勋「有完全的前瞻性」,亲自找营收只有几亿美元的关键零部件小厂,说服对方把产能让给英伟达(剪辑帖)
  • Patel 在同一片段里还说,黄仁勋离开后这些供应商在重新看市场,「谷歌正在向整条供应链求更多产能」,并质疑英伟达只领先最大竞争对手约一年,没了黄仁勋能否保住技术优势
  • 已确认的背景:英伟达 11 月 12 日官宣黄仁勋辞去 CEO 及董事职务,CFO Colette Kress 任临时 CEO,第三财季财报仍按计划于美国时间 11 月 17 日发布;英伟达未公开过供应链协议的签署形式
  • 这些都是个人判断:「握手协议」和「谷歌求产能」没有官方或独立来源证实;请把它当讨论看,不要当成事实
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Altimeter 与 Atreides 联名致信英伟达董事会,呼吁别急着换掉黄仁勋、保留其回归选项;马斯克称会签署「恢复黄仁勋职务」请愿,Gavin Baker 称已有约 2 万人联署

新加坡时间 11 月 14 日 08:34,Atreides Management 管理合伙人兼 CIO Gavin Baker(@GavinSBaker)在 X 上贴出一封他与 Altimeter Capital CEO Brad Gerstner 联名寄给英伟达董事会的信。信中以股东身份请求董事会对公司未来领导层采取「缓慢、审慎、深思熟虑」的流程,保留包括黄仁勋回归在内的所有选项,避免在事实查明前仓促找人接替;同时表示临时 CEO Colette Kress 及团队能胜任过渡。该帖目前约 135 万浏览、9,580 赞、1,160 转发。此前马斯克回复称「有人在发起恢复 Jensen 职务的请愿,我也会签」,这条回复已获约 20.7 万赞;Baker 随后称请愿已有约 2 万人签名,其中约 2000 名英伟达员工(其个人说法,未经独立核实)。也有反对声音:特斯拉高级主任工程师 Yun-Ta Tsai 认为员工若真想要黄仁勋回来,应当以辞职表态。本文是社区讨论,英伟达董事会尚未对信件或请愿作出公开回应。

核心要点速览

  • 信件署名:Altimeter Capital CEO Brad Gerstner 与 Atreides Management 管理合伙人兼 CIO Gavin Baker;Baker 称这是 Atreides 第一次做这类事(原帖)
  • 核心诉求:董事会对未来领导层采取缓慢、审慎的流程,保留黄仁勋回归的选项;若查明事实后董事会仍认为不宜让他回任,那是董事会的权力
  • 马斯克 11 月 14 日(新加坡时间 04:51)回复称会签署恢复黄仁勋职务的请愿,约 20.7 万赞、730 万浏览(原帖)
  • Baker 称请愿约 2 万人签名、含约 2000 名英伟达员工,并表示支持在独立调查结果出来前立即恢复黄仁勋职务;签名数为其个人说法
  • 反方观点:特斯拉 Yun-Ta Tsai 的帖子约 1.7 万赞,认为员工应以辞职表态;英伟达官方暂无回应,11 月 17 日(美国时间)财报电话会是下一个观察点
阅读全文
AD赞助内容

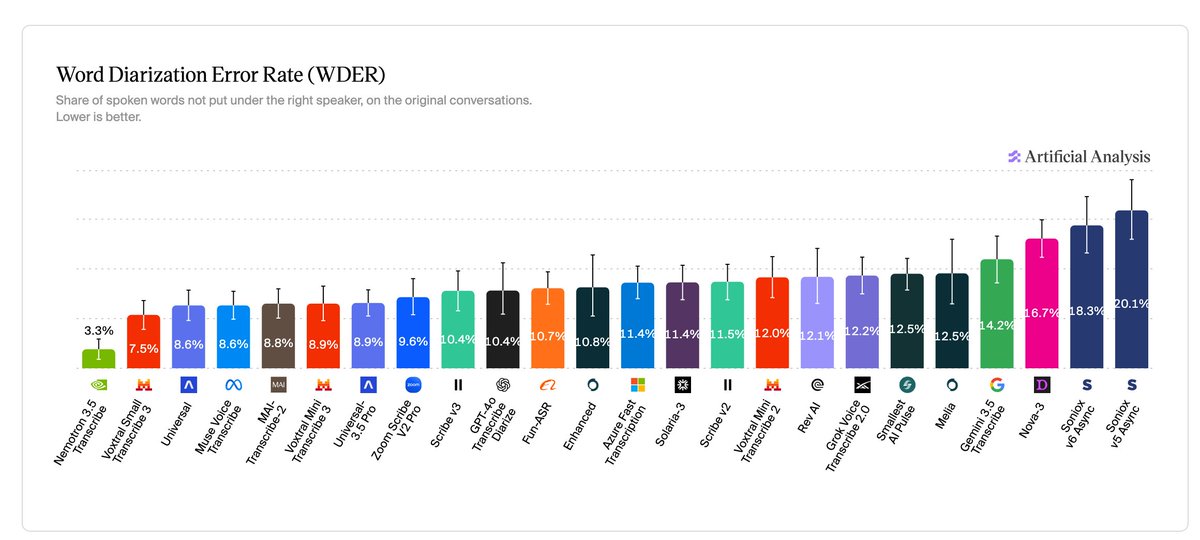
Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

Artificial Analysis 11 月 13 日发布 Diarization Index,专门衡量语音转文字 API 能否把每个词归到真正说话的人:指标是 WDER(被分给错误说话人或无人说话的词占比),测试集为 97 段 2–8 人英文对话,按 2 人、3–4 人、5–8 人三档等权平均。NVIDIA 开源权重的 Nemotron 3.5 Transcribe 以 3.3% 居首,Voxtral Small Transcribe 3 以 7.5% 排第二,也是有标价 API 里最准的;MAI-Transcribe-2 为 8.8%,速度最快之一。

Artificial Analysis 推出 Diarization Index 说话人分离基准:按词级说话人错误率 WDER 评测语音转文字 API,NVIDIA Nemotron 3.5 Transcribe 以 3.3% 领先,Voxtral Small Transcribe 3 以 7.5% 居次

核心要点速览

  • 新指标 WDER =(分错说话人的词 + 无人说话时段的词)÷ 参与评分的参考词数,越低越好;AA 称不用 DER,因为对 API 而言 DER 主要在考词时间戳而不是谁在说话
  • 测试集 97 段对话、每段约 2–9 分钟、总时长约 6.8 小时,真实与合成语音混合,大部分音频为私有留出集,另含约 126 分钟公开的 NOTSOFAR-1 会议录音
  • 评测时直接调用各 API 并开启说话人分离,不告诉模型有几个人在说话,整段音频一次送入;价格包含单独收费的分离功能
  • Nemotron 3.5 Transcribe 2 人对话 WDER 1.7%,5–8 人时也只有 5.6%;在人数最多的一档,其他所有 API 的 WDER 都超过 10%
  • Voxtral Small Transcribe 3 为 7.5%、每千分钟 4 美元;MAI-Transcribe-2 为 8.8%、每千分钟 1.67 美元,每等 1 秒可转写 93.7 秒音频;Nemotron 3.5 Transcribe 是开源权重模型,AA 未列价格
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe⚡ Voxtral Small Transcribe 3⚡ MAI-Transcribe-2🌐 Artificial Analysis🌐 NVIDIA🌐 Mistral AI🌐 Microsoft

RadixArk 用英伟达 Vera CPU 跑智能体强化学习沙箱:同样负载下每轮比 AMD Turin 快约 12%,满载时单路可扛 x86 的 1.3–2.1 倍

LMSYS 博客 11 月 13 日发布 RadixArk Miles 团队文章:开源 RL 后训练框架 Miles 首次把智能体强化学习的全部沙箱放到英伟达 Vera CPU 上端到端训练 GLM-4.7-Flash。在机器已被其他任务占满的条件下,沙箱放在 AMD EPYC Turin 上时每轮平均多花 12%;满载时 Vera 单路可承载的负载是 Xeon 6 的 1.3–1.5 倍、Turin 的 1.4–2.1 倍。

RadixArk 用英伟达 Vera CPU 跑智能体强化学习沙箱:同样负载下每轮比 AMD Turin 快约 12%,满载时单路可扛 x86 的 1.3–2.1 倍

核心要点速览

  • Miles 在 Vera 上跑了 68 个训练步、2,400 多轮,同步和全异步两种模式都无需改训练代码;为此把 Terminal-Bench 和 SWE-bench 中 530 个任务的环境重建为 arm64
  • 对照实验(同模型、同任务、同 GPU,每边 5 步 160 轮):沙箱放在 Turin 上每轮平均多 53 秒,其中智能体命令多 26 秒(慢 60%),验证器多 11 秒
  • 满载时 Vera 每核在 Python 和编译类工作上只慢 5%–22%,Turin 每核慢 40%–70%;176 个并发轮次的 Vera 仍快于只跑 24 轮的 Turin
  • 团队推算:推理再快 8 倍时,Turin 上每轮会比 Vera 长 33%,快 32 倍时长 41%(为推算值,非实测)
  • 以上均为 RadixArk 与英伟达合作的自测结果,x86 机器用 AWS 默认设置,Vera 用英伟达调优的启动参数
阅读全文
关联模型 / 智能体 / 厂商:

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

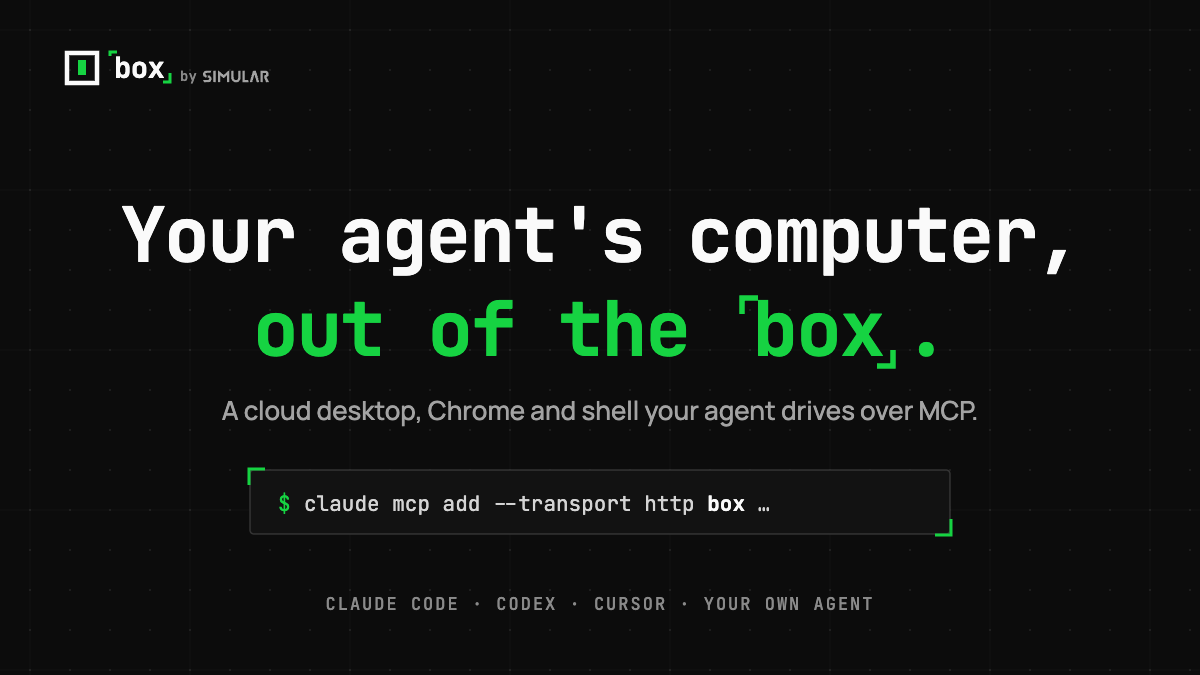
11 月 12 日(UTC),获 Felicis 和英伟达投资的电脑操作智能体公司 Simular 发布 box:每个账号一台云端 Ubuntu 桌面,自带 Chrome 和常驻 shell,整体作为一个远程 MCP 服务器(mcp.box.simular.ai/mcp,Streamable HTTP,OAuth 登录)提供。claude.ai、ChatGPT、Gemini、Claude Code、Codex、Cursor、OpenCode、VS Code 等任何 MCP 客户端都能接入,不同助手可以在同一台机器上接力干活,共享登录状态和文件。用户可在网页或 iPhone 上实时观看,需要登录或付款确认时随时接管。桌面本身免费,模型调用消耗账号积分;空闲时休眠、约 1 秒唤醒,连续休眠 14 天会被删除。发布视频浏览量超过 81 万。官方称「生产环境最快的电脑操作」,但未公布跑分。

Simular 推出 box:一台挂在远程 MCP 上的云端 Linux 桌面,Claude、ChatGPT、Gemini、Claude Code、Codex、Cursor 共用同一台电脑,桌面免费、模型调用按积分计费

核心要点速览

  • 接入方式:一个远程 MCP 地址 mcp.box.simular.ai/mcp,OAuth 登录;Claude Code 一行 claude mcp add --transport http box ... 即可,CI 场景可用 cb_ 开头的个人密钥
  • 安装器 npx @simular-ai/[email protected] connect 会自动发现本机的 Claude Code、Codex、Cursor、OpenCode、Hermes、OpenClaw、VS Code 并写入配置,doctor/remove 可检查和撤销
  • 计费:桌面免费,模型调用用账号积分;空闲约 1 秒唤醒,连续休眠 14 天删除整台机器和文件
  • Secrets 功能:API 密钥加密存储,AI 只看到替身值,box 仅在发往指定域名的请求里替换成真实密钥
  • 官方发布视频约 81.5 万浏览;「最快电脑操作」为厂商口径,官方未公布 OSWorld 等跑分
阅读全文

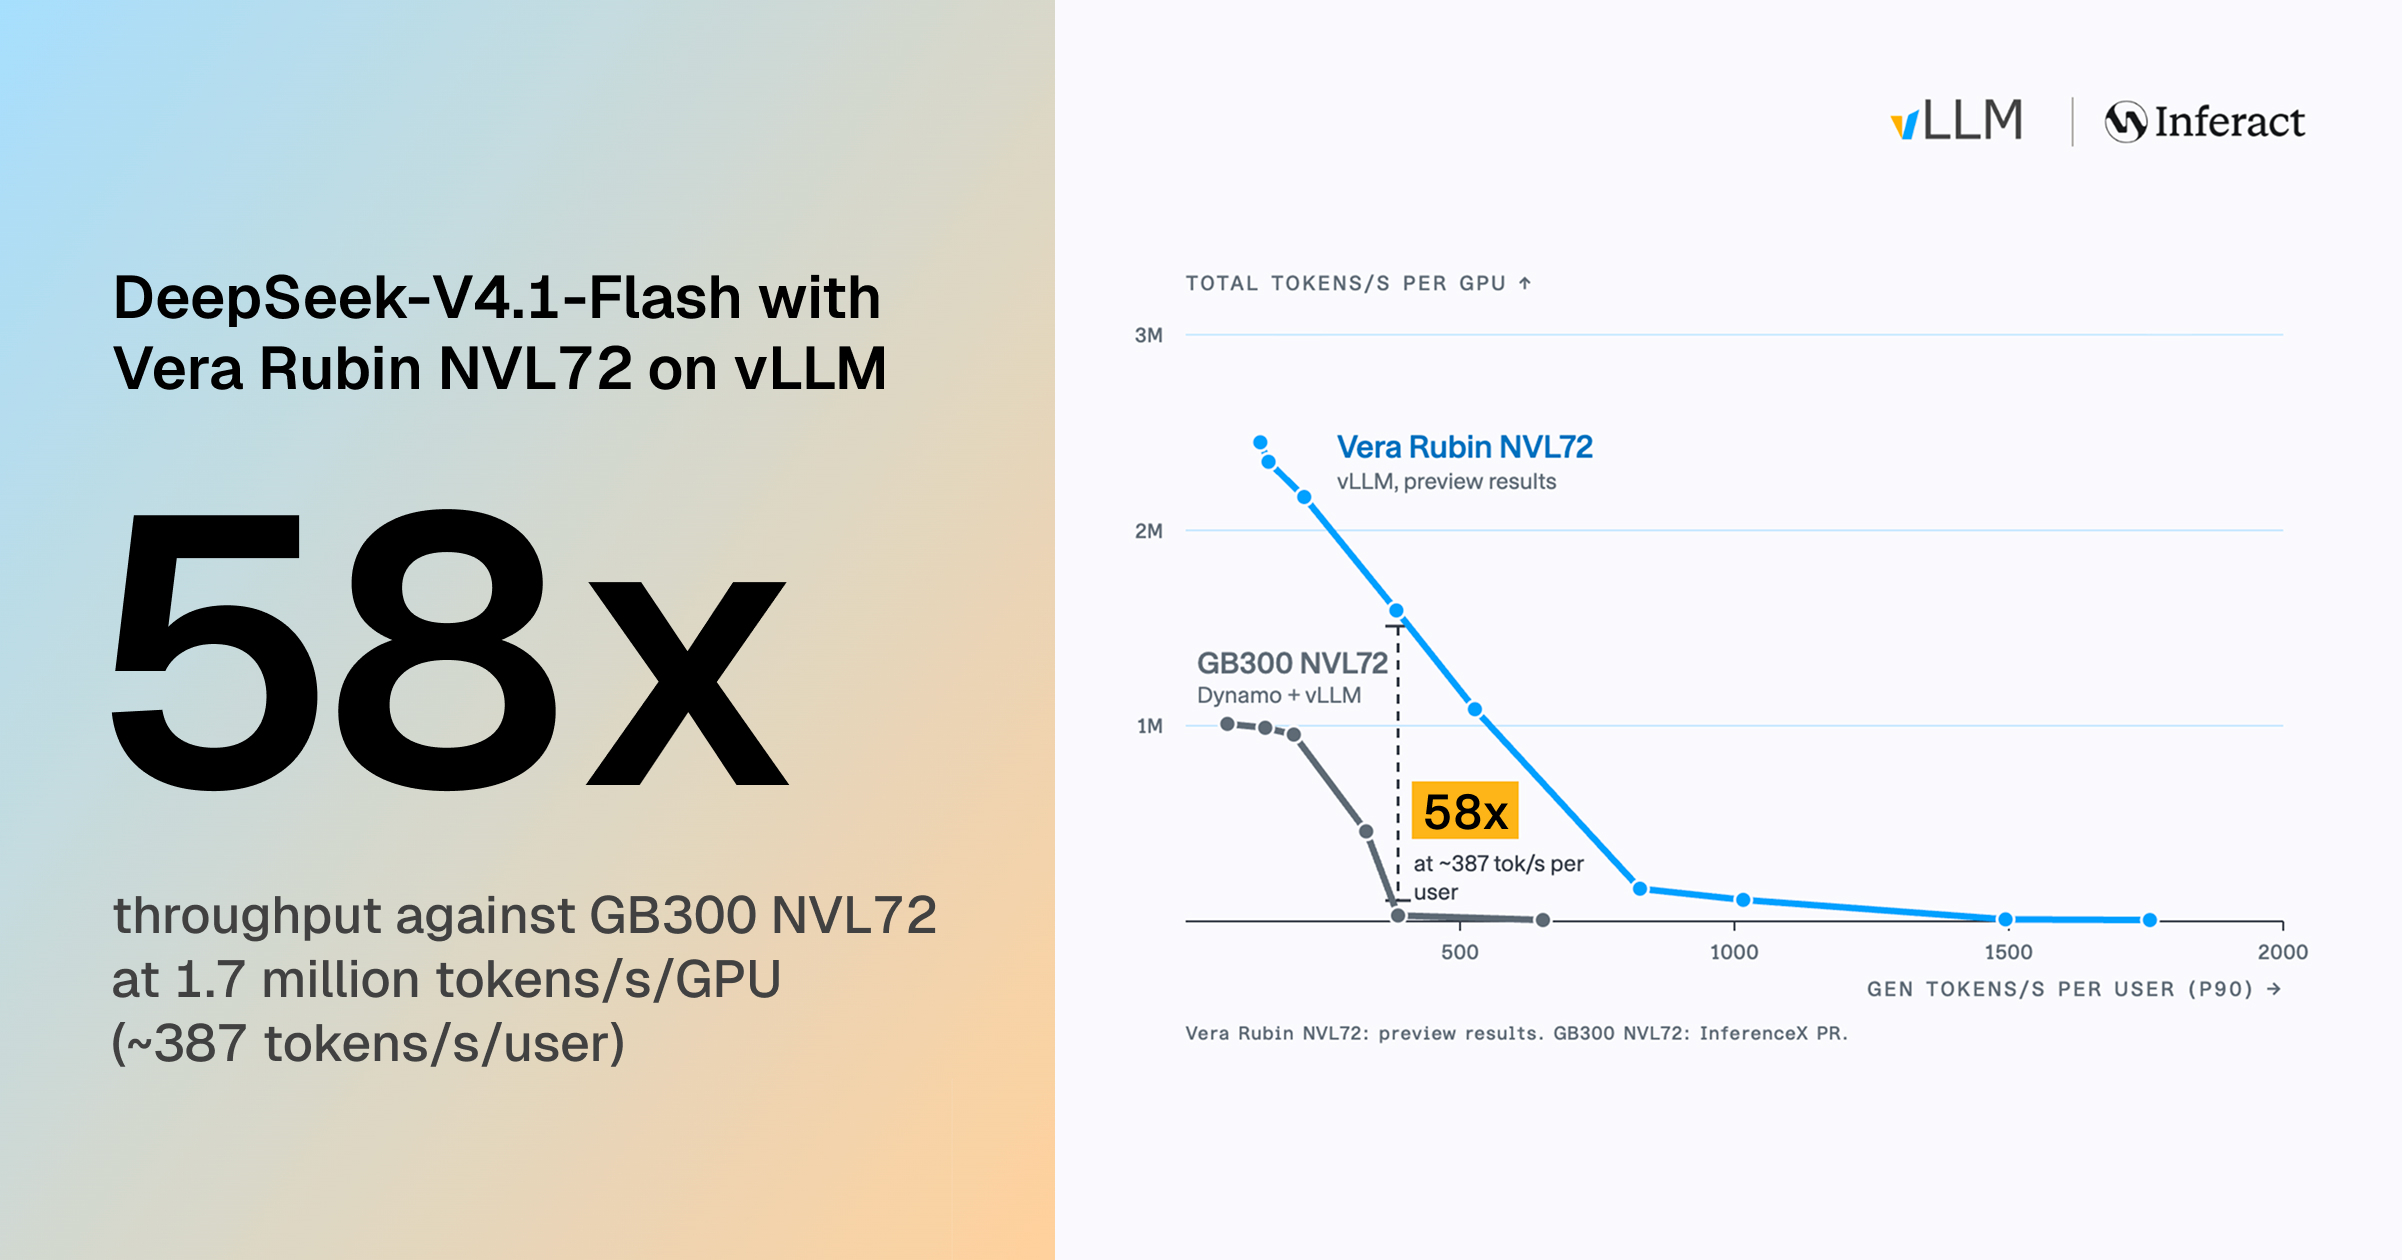
vLLM 在英伟达 Vera Rubin NVL72 上跑 DeepSeek-V4.1-Flash:每用户 387 token/s 时单卡 170 万 token/s,为 GB300 NVL72 的 58 倍;峰值吞吐则是 2.7 倍

11 月 12 日,vLLM 发布 DeepSeek-V4.1-Flash 系列第三篇博客(Inferact 主导):在一台 Vera Rubin NVL72 上,用 SemiAnalysis AgentX 负载测得每用户 P90 387 token/s 时单 GPU 总吞吐 170 万 token/s,是 GB300 NVL72 同一交互速度下的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍。58 倍只对应高交互速度这一点,Rubin 数据为预览结果。

vLLM 在英伟达 Vera Rubin NVL72 上跑 DeepSeek-V4.1-Flash:每用户 387 token/s 时单卡 170 万 token/s,为 GB300 NVL72 的 58 倍;峰值吞吐则是 2.7 倍

核心要点速览

  • 两个倍数要分开看(vLLM 口径):每用户 387 token/s 时 170 万 token/s/GPU,是 GB300 的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍
  • 单用户延迟:TP8 跨两个计算托盘的专用解码路径,并发 1 时 P90 达 1,810 token/s,P50 从 1,117 提升到 1,844 token/s
  • 内核重写:针对 Rubin 的双内存域和 SM107 新 MMA 指令,DEP2 prefill 步约快 28%,DEP decode 步约快 25%
  • 机架级内存池:Mooncake KV 池从 DRAM 扩到空闲 HBM,Engram 表分片到各 GPU HBM;并发 4,800 时请求量多 68%,TTFT P50 从 29.8 秒降到 4.2 秒
  • 数据性质:Rubin 结果为预览数据,GB300 对比来自 InferenceX PR,部分点为插值
阅读全文

X 热议:前 OpenAI 研究员 Will DePue 发布「检查点取证」报告,称在 DeepSeek、Kimi、MiniMax、蚂蚁 Ling 的 6 款开源模型权重里找到英伟达 Blackwell 初始化指纹;报告自称不能证明违反出口管制

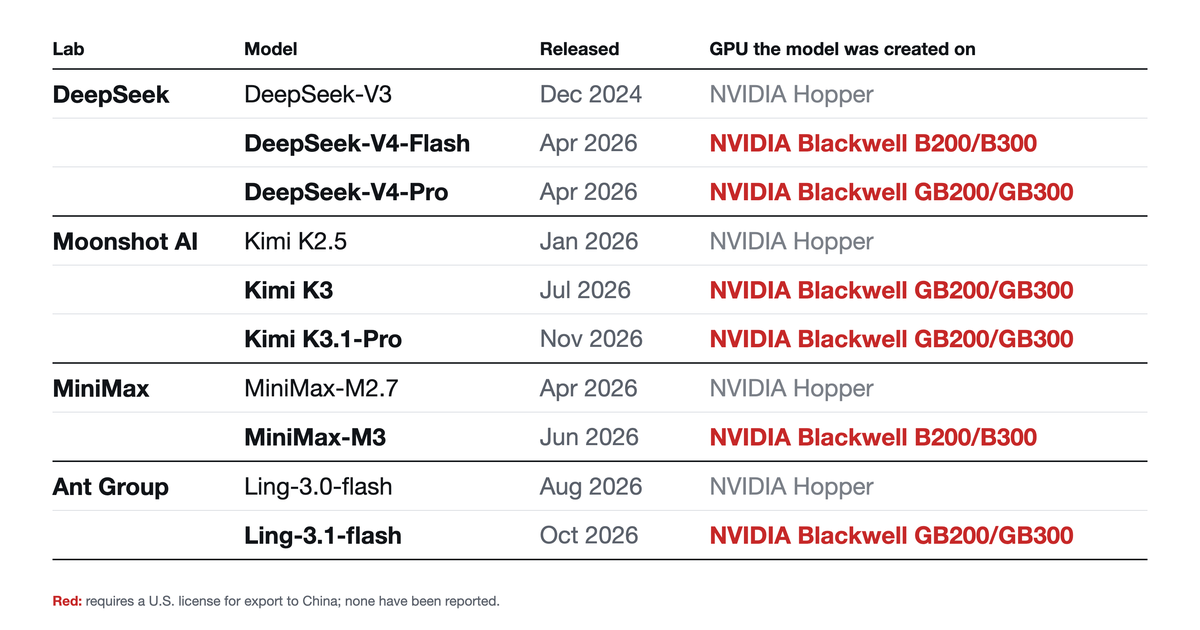
11 月 12 日,前 OpenAI 研究员 Will DePue 在 X 发帖并发布报告,称通过分析公开权重里残留的随机初始化模式,发现 DeepSeek-V4-Flash/Pro、Kimi K3/K3.1-Pro、MiniMax-M3、Ling-3.1-flash 六款模型是在英伟达 Blackwell 上初始化的,而这些公司更早的模型对应 Hopper。帖子约 205 万浏览、2 万赞。这是个人研究结论,不是官方认定;报告本身也写明,它不能确定芯片在哪里、如何获得,也不能确定是否违反出口管制。

X 热议:前 OpenAI 研究员 Will DePue 发布「检查点取证」报告,称在 DeepSeek、Kimi、MiniMax、蚂蚁 Ling 的 6 款开源模型权重里找到英伟达 Blackwell 初始化指纹;报告自称不能证明违反出口管制

核心要点速览

  • 6 款模型被判为 Blackwell 初始化(作者口径):DeepSeek-V4-Flash、MiniMax-M3 对应 B200/B300(148 个 SM);DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、Ling-3.1-flash 对应 GB200/GB300(152 个 SM)
  • 方法:PyTorch 用 Philox 随机数按线程数填充初始权重,线程数由 GPU 的 SM 数决定;作者搜索约 6 万亿种「种子 + 布局」组合去匹配公开权重
  • 统计强度(作者口径):随机巧合最多约 8 sigma,六款模型的最强证据在 49–1,385 sigma 之间;在 24 个开发者公开过训练硬件的模型上,方法结论全部一致
  • 并非所有中国实验室:报告称 Qwen、GLM、腾讯、小米、阶跃的最新模型仍读作 Hopper,美团 LongCat-2.0 未发现英伟达指纹
  • 规模估算不确定:作者估计五次训练合计约 1.2 万张 Blackwell(区间 7,000–20,000),并明确说对估算「没有信心」;文中「OpenAI、Anthropic 资深研究员已独立验证」为其本人说法
阅读全文

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

11 月 12 日,开源推理引擎 SGLang 背后的非营利组织 LMSYS Org 在旧金山首届 SGLang 峰会开幕主题演讲上宣布成立 SGLang 联盟。创始成员包括NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal 和 RadixArk,它们将与 SGLang 维护者一起参与路线图制定,重点方向是前沿模型支持、推理与多模态负载、分布式推理和跨硬件优化。每家成员指派一名技术代表,每年参加两次路线图会议;技术决策和代码合入权仍归 SGLang 维护者,项目继续对整个社区开放。

LMSYS 在首届 SGLang 峰会成立 SGLang 联盟:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk 成为创始成员,共同参与开源推理引擎路线图

核心要点速览

  • 创始成员 8 家:NVIDIA、AMD、Intel、Google、Meta、Cloudflare、Modal、RadixArk(SGLang 核心作者创办的公司),覆盖 GPU/CPU 芯片、云和推理服务商
  • 治理方式:每家指派一名技术代表,每年两次路线图会议,期间可组建工作组并公开进展;技术决策与代码合入仍由 SGLang 维护者负责
  • 四个重点方向:前沿模型支持、推理与多模态负载、分布式推理、跨硬件平台优化
  • 规模(官方口径):SGLang 跑在数十万张 GPU 上,用户包括 Meta、微软、Google、亚马逊、Thinking Machines Lab、Cloudflare、Reflection、Modal
  • 背景:LMSYS 引用德勤数据称,2026 年推理约占全部 AI 算力的三分之二,2025 年约为一半;首届峰会 11 月 12–13 日在旧金山 Fort Mason 举行,100 多位演讲者
阅读全文
AD赞助内容

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

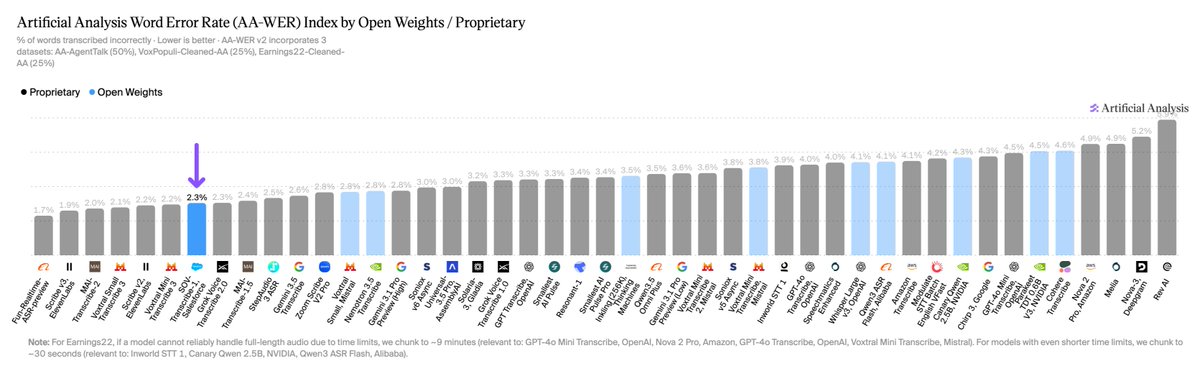
新加坡时间 11 月 13 日 00:30,Artificial Analysis(@ArtificialAnlys)发帖称,Salesforce 新发布的 SOV-Transcribe-1 成为开源权重语音转文字模型第一名:在 AA-WER 指数上词错误率 2.3%,在包括闭源模型在内的 44 个模型中排第 7。它比紧随其后的开源模型 Mistral Voxtral Small 和英伟达 Nemotron 3.5 Transcribe(均为 2.8%)低 0.5 个百分点。模型由 Salesforce 主权 AI(Missionforce Sovereign AI)团队开发,总参数 26.6B、激活参数 4.6B,结构是 Whisper large-v3 音频编码器加 Gemma 4 26B A4B MoE 解码器,权重以 Apache 2.0 许可发布在 Hugging Face。它是非流式模型,适合整段录音转写,不适合实时字幕。

Salesforce 开源语音识别模型 SOV-Transcribe-1:Artificial Analysis 词错误率 2.3%,开源第一、总榜第 7;26.6B 总参数仅 4.6B 激活,Apache 2.0 可自托管

核心要点速览

  • AA-WER 2.3%:开源权重第 1、44 个模型中总榜第 7;Voxtral Small 与 Nemotron 3.5 Transcribe 均为 2.8%
  • 分数据集:Earnings22 财报电话 4.1%(Voxtral Small 4.8%),VoxPopuli 1.5%(对手 1.8%),AA-AgentTalk 语音客服对话 1.8%,与 Nemotron 持平
  • 26.6B 总参数 / 4.6B 激活;Whisper large-v3 编码器 + 投影层 + Gemma 4 26B A4B MoE;BF16,单段音频实测最长 30 分钟,支持英法德西意葡荷 7 种语言
  • 官方称 VoiceCodeBench(电话号码、邮箱等实体)任务成功率 76.3%、实体召回 93.4%,23 个系统中排第 2;AppTek 14 种英语口音平均 WER 8.21%,其中 8 种口音最低(含新加坡英语)
  • Apache 2.0;可用 vLLM 插件(vLLM 0.32.0)或 Transformers 部署;官方实测单张 RTX PRO 6000 Blackwell 每秒可转写 1,039 秒音频(配合 DFlash 草稿模型)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SOV-Transcribe-1⚡ Voxtral Small⚡ Nemotron 3.5 Transcribe⚡ Gemma 4⚡ Whisper large-v3🌐 Salesforce🌐 Artificial Analysis🌐 Mistral AI🌐 NVIDIA🌐 Google

X 热议:黄仁勋辞职半小时后,Hugging Face CEO Clem Delangue 发帖称「真是难过的一天」,但会「比以往更努力地为开源 AI 而战」;Raschka、Nathan Lambert 担心英伟达 Nemotron 开源路线与待交割的 Hugging Face 收购

新加坡时间 11 月 12 日 22:18,也就是英伟达官宣黄仁勋辞职约 29 分钟后,Hugging Face 联合创始人兼 CEO Clem Delangue(@ClementDelangue)发帖:「这整件事很糟糕,我希望它从没发生。真是难过的一天!但我想说清楚一点:我们会继续为开源 AI 而战,而且比以往更努力。」帖子本身没有点名黄仁勋或英伟达,但发布时间和评论区讨论都指向这次 CEO 交接。背景是英伟达 9 月已同意以 129.3 亿美元收购 Hugging Face,交易预计 2027 年上半年完成,尚待监管批准。截至发稿,该帖约 16.4 万浏览、4,800 赞、215 条回复。同一时段,Sebastian Raschka 写道「希望 Nemotron 继续做下去」,Nathan Lambert 也向英伟达 Nemotron 和 Hugging Face 团队喊话支持。本文是社区讨论,不代表英伟达或 Hugging Face 官方对后续安排的表态。

核心要点速览

  • Clem Delangue 帖子发于英伟达公告后约 29 分钟,约 16.4 万浏览、4,800 赞、436 转发、215 回复;原帖未点名黄仁勋
  • 英伟达 9 月 3 日官宣以 129.3 亿美元收购 Hugging Face(约 119 亿美元给股东,最多约 10 亿美元员工留任激励),预计 2027 年上半年交割,仍待监管批准
  • 官方收购公告承诺:Hugging Face 保持开放,不强制使用英伟达算力,继续支持多云和多种加速器
  • 英伟达官方称已在 Hugging Face 发布 500+ 个模型和 250+ 个开放数据集;Raschka 认为 Nemotron 的开放数据和完整训练配方最难被替代
  • 11 月 12 日 CEO 交接公告称运营、客户承诺和产品路线图预计不受影响,未单独提及 Hugging Face 交易或 Nemotron
阅读全文
关联模型 / 智能体 / 厂商:

英伟达官宣 CEO 交接:黄仁勋辞去总裁、CEO 及董事职务即刻生效,CFO Colette Kress 出任临时 CEO,Harvey Jones 成为公司首位董事会主席

11 月 12 日晚(新加坡时间 21:49),英伟达官方新闻账号 @nvidianewsroom 发布公告:董事会宣布创始人黄仁勋辞去总裁、首席执行官和董事职务,即刻生效。现任执行副总裁兼 CFO Colette Kress 出任临时 CEO,同时继续担任 CFO;董事会开始物色正式 CEO,内外部人选都会考虑。前 Synopsys CEO Harvey C. Jones 被任命为英伟达史上首位董事会主席。公告称公司运营、客户承诺和产品路线图预计不受影响,第三财季财报仍按原计划于美国时间 11 月 17 日发布。据 TechCrunch、The Verge 等媒体报道,此前数日黄仁勋因婚外情及其引发的国家安全争议承受辞职压力;官方公告未提及原因。该帖约 280 万浏览、3.6 万赞。

英伟达官宣 CEO 交接:黄仁勋辞去总裁、CEO 及董事职务即刻生效,CFO Colette Kress 出任临时 CEO,Harvey Jones 成为公司首位董事会主席

核心要点速览

  • 官方公告:黄仁勋辞去总裁、CEO 和董事职务,即刻生效,结束自 1993 年创立公司以来(公告称 33 年)的掌舵
  • CFO Colette Kress(2013 年 9 月加入)任临时 CEO 并兼任 CFO;董事会启动正式 CEO 遴选,内外部候选人均考虑
  • Harvey C. Jones 成为英伟达首位董事会主席;据 TechCrunch,他自 1993 年起就在董事会
  • 据 TechCrunch:英伟达股价周四早盘跌近 12%,自上周五以来最多跌 19%,市值蒸发超 8,550 亿美元
  • 第三财季财报仍定于美国时间 11 月 17 日 13:20(太平洋时间)发布,14:00 召开电话会
阅读全文
关联模型 / 智能体 / 厂商:

ElevenLabs 纽约峰会发布 Agent 全家桶:Interaction Engine 按对话环节自动切换便宜模型与前沿模型,ElevenAgents 加入记忆和 Routines,NVIDIA Nemotron 3.5 Super VL 今起可选

ElevenLabs 11 月 11 日在纽约峰会上集中公布了下一阶段的 Agent 路线。已上线的有:NVIDIA Nemotron 3.5 Super VL 进入 ElevenAgents 模型列表;ElevenLabs Partner Program 与 McKinsey 联盟;新应用 ElevenAI 开放免费早期访问。预览或“未来几个月”推出的有:Interaction Engine(管理打断与轮流发言,并为对话每个环节挑选合适的 LLM,简单分流用便宜模型、退款等复杂环节交给前沿模型)、ElevenAgents 的 Memory 与 Routines,以及与企业合作微调开源 LLM 和自家语音模型。

ElevenLabs 纽约峰会发布 Agent 全家桶:Interaction Engine 按对话环节自动切换便宜模型与前沿模型,ElevenAgents 加入记忆和 Routines,NVIDIA Nemotron 3.5 Super VL 今起可选

核心要点速览

  • 已上线:NVIDIA Nemotron 3.5 Super VL 进入 ElevenAgents;在 ElevenAgents 客服任务基准上,端到端任务完成率领先,成本比其他主流开源模型低 70%,关闭推理后跻身平台最快的 3 个模型之列(厂商口径)
  • 预览:Interaction Engine 负责轮流发言和打断,并按对话环节在便宜模型与前沿模型之间切换,省 token
  • 即将推出:Memory 记住老客户提过的偏好与约束;Routines 在通话前、中、后执行多步任务(预审、回拨、写 CRM、发邮件)
  • 生态:合作伙伴超 550 家、覆盖 44 个国家;Marketplace 明年起可用现有 ElevenLabs 承诺额度购买行业 Agent
  • 算力:新增 15 MW NVIDIA Vera Rubin 容量;为波兰全国电子医疗平台(每年约 4000 万次预约)部署本地语音 Agent
阅读全文
关联模型 / 智能体 / 厂商:

Runway 开源世界动作模型 Praxis-1:27B MoE 视频模型直接控制机器人,RoboLab-120 成功率 46.2% 居开源第一,Apache 2.0 可商用

Runway 11 月 11 日以 Apache 2.0 许可开放世界动作模型 Praxis-1 的权重、推理与微调代码(含 LoRA),可商用。它是 27B 参数的 MoE 扩散 Transformer(每 token 激活约 2.8B),同时预测未来视频和机器人动作,每次调用输出 1.6 秒动作,单张 H100 往返约 0.55 秒。官方称在 NVIDIA RoboLab-120 上成功率 46.2%,是世界动作模型和开源机器人基础模型中的第一,高于 FLUX 3 Action 42.9%、π0.5 28.0%。同一工位三项任务上,比让 GPT-6 Astra 直接驱动机械臂快 15.6 倍、单任务成本低 51 倍。权重已上 Hugging Face,并支持 LeRobot 与 vLLM-Omni。

Runway 开源世界动作模型 Praxis-1:27B MoE 视频模型直接控制机器人,RoboLab-120 成功率 46.2% 居开源第一,Apache 2.0 可商用

核心要点速览

  • 规模:总参数 27.2B,主干 26.9B、每 token 激活约 2.8B,另有 314M 动作专家;bf16 约 54.4GB,单张 80GB GPU 可跑
  • RoboLab-120(1,200 回合):46.2%,FLUX 3 Action 42.9%、Cosmos3 Nano 36.8%、π0.5 28.0%(官方口径)
  • 真机 Franka FR3 十项任务:88/100 对 FLUX 3 Action 80/100;RT-1 微调后 SimplerEnv 80.0%(原 RT-1 52.4%)
  • 对比 GPT-6 Astra 驱动同一机械臂:快 15.6 倍,单任务成本 0.04 美元对 1.87 美元(低 51 倍)
  • NVFP4 量化后权重缩到 17.5GB,RoboLab 抽样 46.5% 对 bf16 47.8%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Praxis-1⚡ FLUX 3 Action⚡ pi0.5⚡ GR00T N1.6⚡ GPT-6 Astra🌐 Runway🌐 NVIDIA