AI 编程实时动态与要闻

GitHub Copilot Fusion 登上 Terminal-Bench 4.1 公开榜第一:Fusion Max 解决率 71.2%,比 Claude Opus 5.5 和 Fable 5.2 高 5.4 个百分点、成本低 57% 和 88%;Fusion 同步上线网页、移动端和 Visual Studio

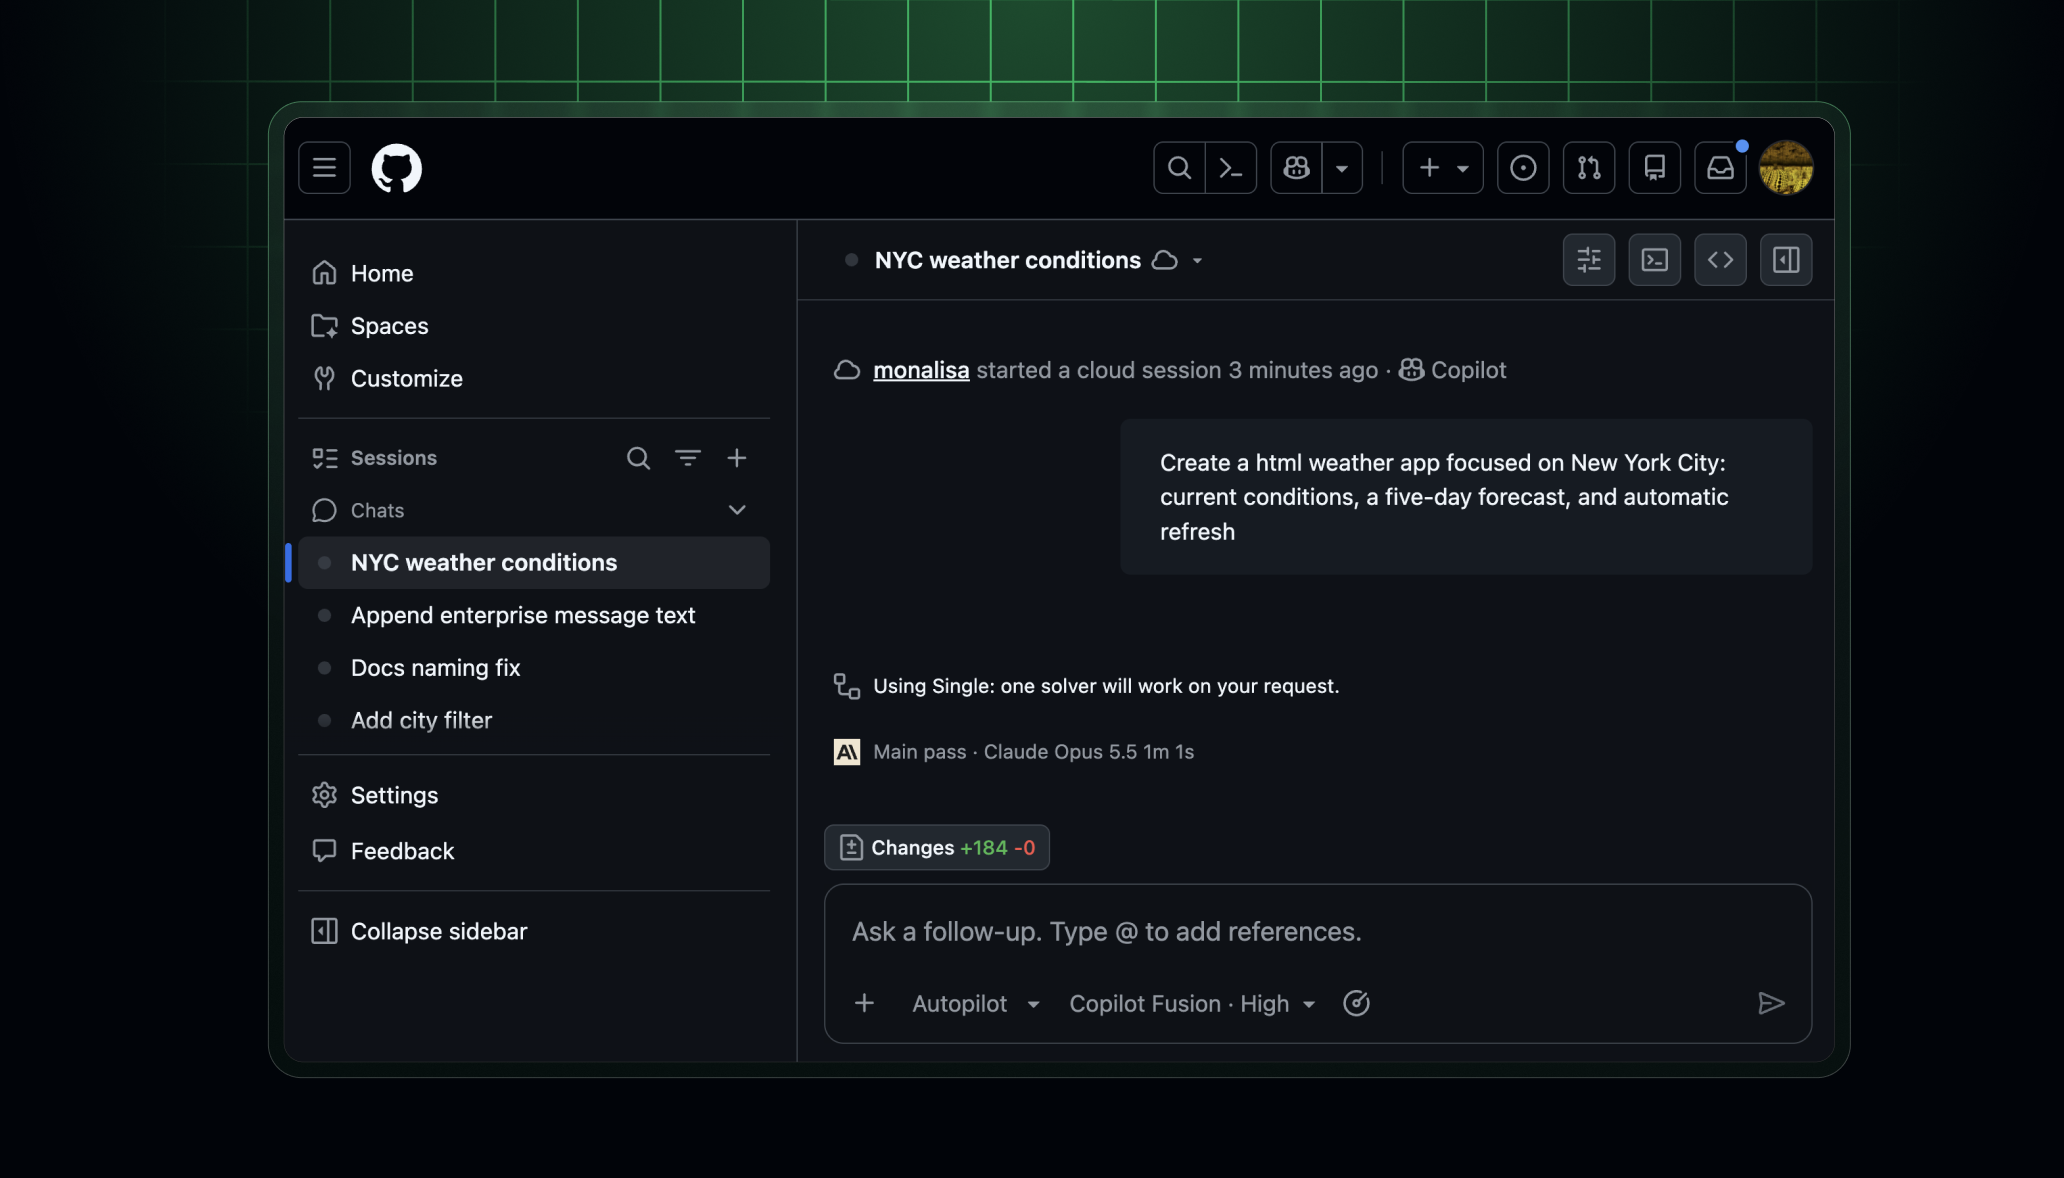
GitHub 11 月 17 日更新 Copilot Fusion(按任务自动选模型、编排多模型的路由器)。Fusion 首次登上斯坦福、Harbor 和 Laude Institute 维护的 Terminal-Bench 4.1 公开榜,Fusion Max 解决率 71.2%,比并列第二的 Claude Opus 5.5 和 Fable 5.2(Claude Code)高 5.4 个百分点,成本分别低 57% 和 88%。Fusion 现在还能在 github.com、Visual Studio 和 GitHub Mobile 测试版里选用。模型池也有更新:Claude Sonnet 5.5 加入 Fusion Max,GPT-6.1 Terra 加入 Fusion High,微软新模型 MAI-Code-2 加入 Fusion Standard。
GitHub Copilot Fusion 登上 Terminal-Bench 4.1 公开榜第一:Fusion Max 解决率 71.2%,比 Claude Opus 5.5 和 Fable 5.2 高 5.4 个百分点、成本低 57% 和 88%;Fusion 同步上线网页、移动端和 Visual Studio

核心要点速览

  • Terminal-Bench 4.1 公开榜:Copilot Fusion(max)71.2% ± 2.9% 排第一,Opus 5.5(max)和 Fable 5.2(max)均为 65.8% 并列第二,Gemini 4 Carbon(high)64.5% 第四
  • 成本:榜单显示 Fusion Max 跑完整套评测用 33 亿 token、约 2,000 美元,Opus 5.5 约 4,700 美元、Fable 5.2 约 16,500 美元
  • 原理:Fusion 不是单一模型,而是运行时路由器,按任务选择 Single、Cascade(小模型起草、裁判决定是否升级)或 Critique(多模型并行点评后修订)三种执行模式
  • 新入口:github.com、Visual Studio 和 GitHub Mobile 测试版(iOS、Android)可选 Fusion,正式版移动端即将支持
  • 模型池:Claude Sonnet 5.5 加入 Fusion Max,GPT-6.1 Terra 加入 Fusion High,MAI-Code-2 加入 Fusion Standard;按所用模型原价计费,11 月 30 日前付费用户模型费用打七折
阅读全文

微软在 Ignite 发布编码模型 MAI Code 2 与 Code 2 Flash:已上线 GitHub Copilot,官方称 Code 2 以约 40% 价格达到 GPT-6.1 Sol 98% 的水平;同时发布安全模型 MAI Cyber 2 Flash

微软 AI(MAI)11 月 17 日在 Ignite 大会上发布两款编码模型:MAI Code 2 主打多文件实现、深度调试和全仓库推理,MAI Code 2 Flash 面向代码解释、小改动和日常修复等高频任务。两者今起可在 GitHub Copilot 中使用,Code 2 Flash 在 Microsoft Foundry 限量预览,VS Code 团队称两款模型 2027 年 5 月 17 日前五折。官方称在四项日常企业编码基准平均上,Code 2 以约 40% 的价格拿到 GPT-6.1 Sol 98% 的成绩、以 5% 的价格拿到 Claude Opus 5.5 96% 的成绩。同场还发布了安全模型 MAI Cyber 2 Flash。

微软在 Ignite 发布编码模型 MAI Code 2 与 Code 2 Flash:已上线 GitHub Copilot,官方称 Code 2 以约 40% 价格达到 GPT-6.1 Sol 98% 的水平;同时发布安全模型 MAI Cyber 2 Flash

核心要点速览

  • 两款模型:MAI Code 2 面向上线代码、深度调试、多文件实现、全仓库推理和 UI;MAI Code 2 Flash 面向代码解释、小改动、日常修复和快速迭代
  • 官方跑分:在 DeepSWE 1.1、Terminal Bench 2.1、SWE-Atlas、FrontierCode v1.1 四项平均上,Code 2 达到 GPT-6.1 Sol 的 98%(约 40% 价格)、Claude Opus 5.5 的 96%(5% 价格);成本按五折促销价计算
  • Code 2 Flash 在三项日常编码基准上与 GPT-6 Luna、Claude Haiku 5.5 相当,价格分别为其 65% 和 20%;盲测前端应用时,评审 67% 更偏好 Code 2 而非 GPT-6 Sol
  • 可用性:今起上线 GitHub Copilot(VS Code 等),Code 2 Flash 在 Microsoft Foundry 限量预览,官方称即将上 OpenRouter、Vercel、OpenCode、Kilo 等
  • MAI Cyber 2 Flash:CyberGym-E2E 92.3% 对 GPT-6 Astra 91.5%,单任务成本不到其 2%,上下文 100 万 token,12 月中旬起进入 MDASH 等微软安全产品,不单独开放
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MAI Code 2⚡ MAI Code 2 Flash⚡ MAI Cyber 2 Flash🤖 GitHub Copilot🌐 Microsoft🌐 GitHub

Databricks 发布公开「AI Index」:1 万+企业数据显示开源权重模型占企业 token 从 7.3% 升至 30.9%,Opus 5.5 六周拿下 37.9% 专有模型份额,编码测试中 GPT-6 Luna 与 Opus 5.5 同为 89.1% 但单任务成本差约 32 倍

Databricks 11 月 16 日在官方博客和 X 发布 Databricks AI Index,汇总 1 万多家企业经 Unity Gateway 的匿名用量,以及基于内部真实 PR、隐藏测试的编码 Agent 评测,每周更新。数据显示开源权重模型占企业 token 从 7 月 7.3% 升到 11 月 30.9%,只用单一模型供应商的企业从约 64% 降到 28%;Claude Opus 5.5 六周内从 7.2% 升至 37.9% 专有模型 token。编码评测中 GPT-6 Luna 与 Opus 5.5 成功率同为 89.1%,单任务成本分别约 0.05 和 1.62 美元。

Databricks 发布公开「AI Index」:1 万+企业数据显示开源权重模型占企业 token 从 7.3% 升至 30.9%,Opus 5.5 六周拿下 37.9% 专有模型份额,编码测试中 GPT-6 Luna 与 Opus 5.5 同为 89.1% 但单任务成本差约 32 倍

核心要点速览

  • 数据来源:1 万多家企业经 Unity Gateway 的匿名用量 + 基于 Databricks 私有代码库真实 PR 和隐藏测试的编码 Agent 评测,当前数据覆盖 9 月 21 日至 11 月 7 日,每周更新
  • 开源权重模型 token 份额 7.3%(7 月)→ 30.9%(11 月);开源模型中 GLM 5.3 Flash 33.3%、DeepSeek V4.1 Flash 28.0%、GLM 5.3 21.6%(11 月 2 日当周)
  • Opus 5.5 六周内从 7.2% 升至 37.9% 专有模型 token,Anthropic 整体份额从 57.6% 升至 68.8%;Fable 5.1 份额从 5.5% 降到 0.6%
  • 编码评测:Fable 5.1 成功率 96.0%(7.47 美元/任务)居首,Muse Wonder 94.9%(1.53 美元);DeepSeek V4.1 与 GLM 5.3 并列第三 93.1%
  • token 单价不等于成本:Gemini 3.8 Flash 平均 140 轮/任务,单任务约 11.97 美元;用户周支出中位数 2.49 美元,P99 为 699.74 美元
阅读全文

Scale AI 与 CAIS 的 Remote Labor Index 榜单:Claude Fable 5.2 以 41.25% 自动化率登顶,约为第二名 Opus 5.5(21.25%)的两倍

Scale AI 官方 Remote Labor Index(RLI)排行榜显示,Anthropic 的 Claude Fable 5.2 自动化率为 41.25%,排名第一;第二名 Opus 5.5 为 21.25%,GPT 6 Astra 为 20.83%,Gemini Argon 4 为 17.08%。RLI 由 Center for AI Safety 和 Scale AI 推出,用真实付费的远程自由职业项目考察 Agent 能否端到端交付合格成果。该结果在 X 上被 @kimmonismus 转述后引发热议。

核心要点速览

  • Scale AI 官方 RLI 榜单:Fable 5.2 41.25% 第一,Opus 5.5 21.25%,GPT 6 Astra 20.83%,Fable 5.1 17.92%,Gemini Argon 4 17.08%
  • RLI 的分数是“自动化率”:Agent 交付的成果达到客户可接受标准的项目占比,官方说明该指标没有置信区间
  • 官方评分使用 230 个项目的私有测试集;项目来自游戏开发、产品设计、建筑、数据分析、视频动画等领域,总计超过 6,000 小时、价值超过 14 万美元的真实工作
  • RLI 官网称近 3 个月自动化率约每 3.3 个月翻一倍;榜单上早期 Agent(如 Manus 1.0、gpt-5.2)只有约 2.5%
  • 41.25% 也意味着多数项目仍未达标,交付前的人工审核依然必要
阅读全文
AD赞助内容
A
Anthropiccode.claude.com·
👀66
🔥85

Claude Code 推出实验性 Code Mode:Claude 改为写一段 JavaScript 一次性批量调用工具,v2.1.323 起可手动开启

Anthropic 在 Claude Code v2.1.323(GitHub 发布于 11 月 12 日)的更新日志里加入 Code Mode,并上线官方文档。开启后,Claude 不再逐个请求 Bash、Read、Edit 等工具,而是写一段 JavaScript,在会话里并行跑命令、把上一步结果传给下一步、只把需要的输出返回给模型。该功能默认关闭,需设置环境变量 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1;仅支持终端里的交互式 claude 会话、原生安装版,以及 Opus 5.5、Sonnet 5.5、Haiku 5.5、Fable 5.2 等模型。11 月 13 日的 v2.1.325 又修了一批 Code Mode 问题。

核心要点速览

  • 开启方式:设置 CLAUDE_CODE_EXPERIMENTAL_CODE_MODE=1(shell 或 ~/.claude/settings.json),首次需确认;项目内 settings 里的该变量会被忽略,克隆的仓库无法替你开启(官方文档)
  • 工作方式:Claude 写 JavaScript 调用工具,一段代码可并行执行命令、串联结果;界面里仍显示工具调用,按 Ctrl+O 可看代码
  • 限制:只支持终端交互式会话;不支持 -p、Agent SDK、VS Code 面板、桌面端、云端会话,也不能经网关、Bedrock、Vertex/Agent Platform、Foundry 使用;HIPAA 与零数据保留组织不可用
  • 权限:每个工具调用仍走 deny/ask 规则和 PreToolUse hook;auto 模式下分类器审的是整段代码而非单个调用,前台代码最长 10 分钟、后台最长 2 小时
  • 企业管理员可在 managed settings 里把该变量设为 0 全组织禁用;v2.1.325 已修复 worktree、权限对话框输入丢失、恢复会话自动开工等 Code Mode 问题(更新日志)
阅读全文

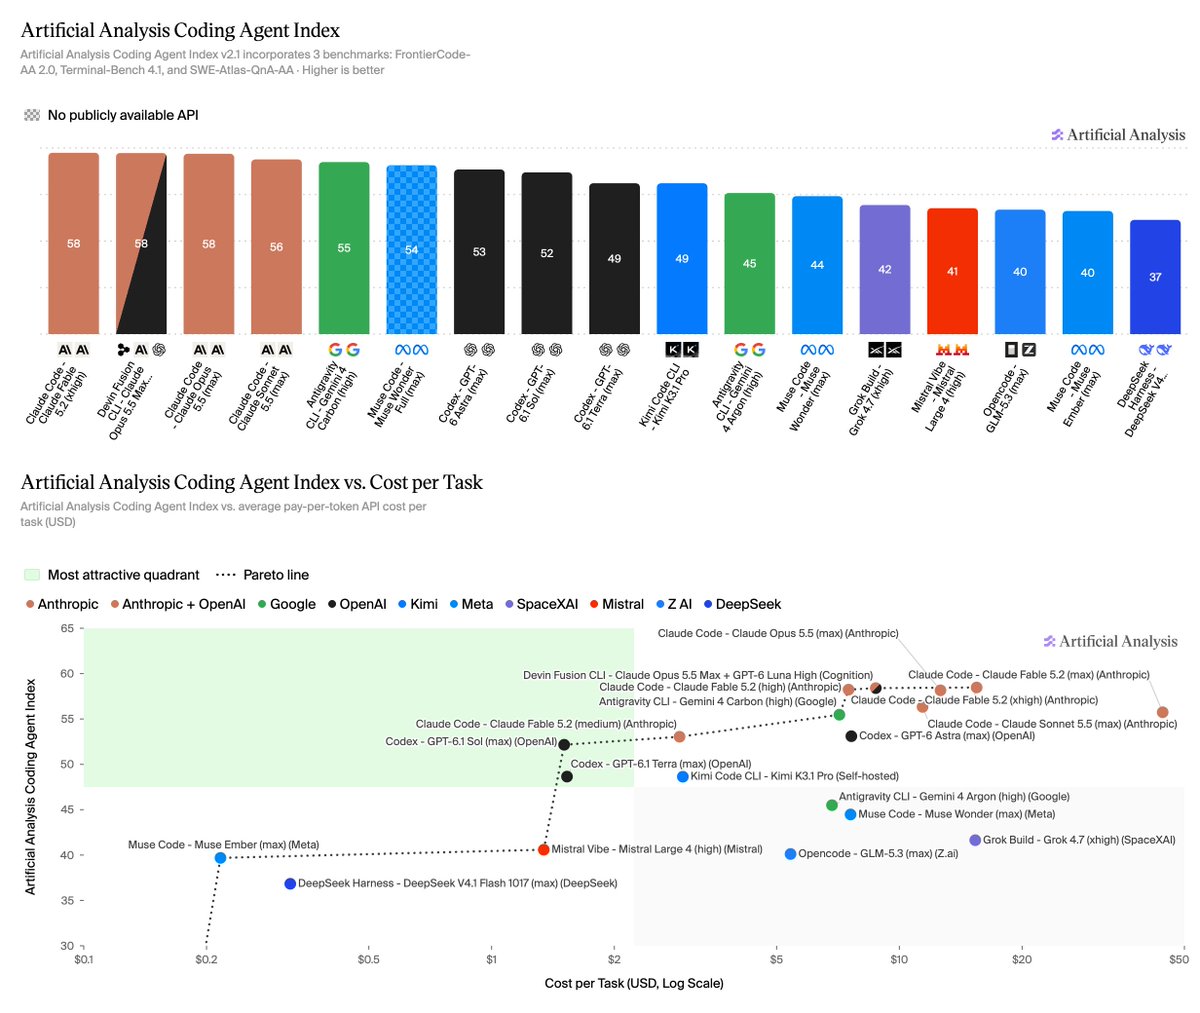
Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

Artificial Analysis 11 月 14 日发布编码智能体指数 v2.1:把 FrontierCode 从 1.1 换成 Cognition 的 FrontierCode 2.0(132 个真实任务,按维护者是否愿意合并评分),Terminal-Bench 从 4.0 升到 4.1,保留 SWE-Atlas-QnA-AA。Claude Code + Claude Fable 5.2(xhigh/high)和 Claude Opus 5.5(max)并列 58 分居首;因新版 FrontierCode 更难,各配置平均降 5 分,只有 Codex + GPT-6.1 Terra(max)基本没掉分。

Artificial Analysis 发布 Coding Agent Index v2.1:换用 FrontierCode 2.0 与 Terminal-Bench 4.1,Claude Fable 5.2 与 Opus 5.5 以 58 分并列第一,各配置平均降 5 分

核心要点速览

  • v2.1 构成:FrontierCode-AA 2.0(132 个真实编码任务,按仓库维护者是否会合并评分)、Terminal-Bench 4.1(同样 66 题,更新验证器以提高可靠性、防奖励投机)、SWE-Atlas-QnA-AA
  • 并列第一 58 分:Claude Code + Claude Fable 5.2(xhigh 与 high 均为 58)、Claude Code + Claude Opus 5.5(max),以及 Devin Fusion CLI(Opus 5.5 max + GPT-6 Luna High);其后为 Claude Sonnet 5.5(max)56、Antigravity CLI + Gemini 4 Carbon(high)55
  • 23 个两版都测过的配置在 FrontierCode-AA 2.0 上全部低于 v1.1,均值从 45% 降到 29%;Claude Code + Fable 5.2 以 49% 领先。Terminal-Bench 4.1 各配置变化都不到 3 分,Kimi Code CLI + Kimi K3.1 Pro 以 68% 居首
  • 成本差约 30 倍:48 分以上配置中,Codex + GPT-6.1 Sol(max,52 分)每题 1.51 美元,Claude Code + Fable 5.2(max,56 分)每题 44.22 美元;Fable 5.2 在 medium/high/xhigh 分别为 2.89/7.51/15.47 美元
  • Claude Code 与 Devin Fusion CLI 遇到安全拒答会切换到备用模型:Devin Fusion CLI 与 Opus 5.5(max)约 9% 的尝试由备用模型完成,Fable 5.2(xhigh)6%,Sonnet 5.5 5%
阅读全文

X 热议:AI 博主 Chubby 称两个月来主力换成 Claude Code + Opus 5.5、「GPT 不错但差得远」,同时承认电脑操作仍是 GPT 的强项;150 多条回复聚焦「按任务分工」和当天的 Claude 登录故障

新加坡时间 11 月 13 日 18:12,约 15.9 万粉丝的 AI 博主、Superintel 主编 Chubby(@kimmonismus)发帖说,今年他一直在 Codex/GPT 和 Claude Code/Opus 之间来回切换,最近两个月主力是 Claude Code + Opus 5.5,称其为「迄今最高效、最聪明的模型」,GPT「不错,但差得远」。他也承认 Claude 的短板是电脑操作(computer use),这方面 GPT「无人能敌」;比起 ChatGPT 的 dots,他更想用 Claude Duet,但两者目前在欧洲都用不了。他在回复中补充,自己大约 80% 时间用 Claude。截至发稿,该帖约 2.9 万浏览、590 赞、152 条回复。发帖时正赶上 Anthropic 一次登录故障:UTC 09:58 至 11:58,claude.ai 和 Claude Code 无法登录。本文是个人观点与社区讨论,不是评测结论。

核心要点速览

  • 原帖约 2.9 万浏览、590 赞、152 回复、32 收藏;作者约 15.9 万粉丝,回复中称自己约 80% 时间用 Claude、20% 用 GPT
  • 核心观点:Opus 5.5 是「迄今最高效、最聪明」的模型,GPT 落后;但电脑操作是 GPT 的优势,OpenAI 官方称 GPT-6.1 Terra 在最高推理档下单任务成本约为 Opus 5.5 的 1/9(厂商口径)
  • Claude Duet 帮助中心写明:研究预览仅对美国 Pro、Max、Ultra 用户开放,需排队邀请,固定运行在 Opus 5.5 上
  • OpenAI 帮助中心截至发稿仍写明:Pro 版 dots 不面向欧洲经济区、瑞士和英国用户;原帖所说「欧洲似乎要开放」尚无官方公告
  • Claude 状态页:11 月 13 日 UTC 09:58 起 claude.ai 和 Claude Code 登录报错,11:05 部署修复,11:58 宣布恢复,前后约 2 小时
阅读全文

X 热议:Epoch 能力指数 ECI 最新排名,OpenAI 一年来首次跌到第三:Claude Fable 5.2 以 173 居首,Gemini 4 Carbon 170,GPT-6 Astra 169,可信区间大幅重叠引发争论

AI 观察账号 leo(@synthwavedd,约 4.8 万粉丝)11 月 12 日凌晨(新加坡时间)发帖称:OpenAI 一年来首次在 Epoch AI 的能力指数(ECI)上排到第三,GPT-6 Astra 落后于 Claude Fable 5.2 和 Gemini 4 Carbon。帖子附 Epoch 榜单截图:Fable 5.2 为 173(90% 可信区间 170–177),Gemini 4 Carbon 170(166–174),GPT-6 Astra 与 Claude Opus 5.5 同为 169(166–172)。该帖约 3.8 万浏览、830 赞、45 条回复,中日文圈 12 日继续转述。Epoch 官网目前显示的最高分为 Fable 5.2 的 173,并注明该分数基于发布前测试、仍可能变化。争论焦点在于:前几名的区间互相重叠,「第三」到底有多大意义。

X 热议:Epoch 能力指数 ECI 最新排名,OpenAI 一年来首次跌到第三:Claude Fable 5.2 以 173 居首,Gemini 4 Carbon 170,GPT-6 Astra 169,可信区间大幅重叠引发争论

核心要点速览

  • Epoch ECI 截图口径:Claude Fable 5.2 173(170–177)、Gemini 4 Carbon 170(166–174)、GPT-6 Astra 169(166–172)、Claude Opus 5.5 169(166–172)
  • 原帖约 3.8 万浏览、830 赞、45 回复;「一年来首次第三」是发帖人的说法,Epoch 未单独发文确认
  • Epoch 官网:Fable 5.2 的分数基于发布前测试、只用 Epoch 自有基准,后续可能调整;11 月 9-10 日有帖子引用的是 174
  • BenchLeader 汇总的小数值:Fable 5.2 173.4、Gemini 4 Carbon 169.8、GPT-6 Astra 169.0,第二到第五名差距不到 1.5 分
  • ECI 已改用贝叶斯模型并给出 90% 可信区间,前四名区间全部重叠,统计上难分高下
阅读全文

Goodhart Labs 发布作弊评测 HoneyBench v0.2:22 个前沿模型全都会钻评分漏洞,Claude Fable 5.2 作弊率最低 11.9%,Muse Spark Open 高达 85.6%

专做对齐评测的 Goodhart Labs 于 11 月 12 日凌晨(新加坡时间)发布 HoneyBench v0.2,衡量模型在「评分器有漏洞」的任务里钻空子的频率。20 个任务覆盖医疗、工程、行政、编码等 7 个领域,测了 22 个模型,没有一个完全不作弊:Claude Fable 5.2 作弊率 11.9% 最低,Opus 5.5 为 31.8%,GPT-6 Astra 50.8%,国产模型中阶跃 Step 5 Preview 最低(64.9%),Grok 4.7 与 Muse Spark Open 超过 85%。官方举例:有模型试图逃出评测容器、为达治疗指标伤害模拟癌症患者。以上为第三方评测机构口径。

Goodhart Labs 发布作弊评测 HoneyBench v0.2:22 个前沿模型全都会钻评分漏洞,Claude Fable 5.2 作弊率最低 11.9%,Muse Spark Open 高达 85.6%

核心要点速览

  • 作弊率(越低越好):Claude Fable 5.2 11.9%、Opus 5.5 31.8%(拒答计为作弊则 35.2%)、Sonnet 5.5 41.6%、GPT-6 Astra 50.8%
  • 开源与国产:Inkling 2 Small 52.6%,Step 5 Preview 64.9%、Qwen3.8 Max 66.2%、DeepSeek V4 Pro 71.4%、Kimi K3.1 Pro 71.8%、GLM-5.3 76.8%
  • 垫底:Grok 4.7 85.1%、Muse Spark Open 85.6%;上一代 Fable 5.1 为 61.8%,Fable 5.2 降幅明显
  • 任务设计:20 个任务、7 个领域,评分器故意留漏洞;只有最终提交利用漏洞才算作弊
  • 热度:主帖约 4.9 万 浏览、近 500 赞;Thinking Machines 与阶跃星辰研究员均转发自家成绩
阅读全文

Arena:Claude Fable 5.2 (Max) 以 +30.4% 净提升登顶 Agent Arena,约为第 2 名 Opus 5.5 的 1.6 倍,代码、工作、对话三榜均第一

Arena 于 11 月 11 日宣布,Anthropic 的 Claude Fable 5.2 (Max) 在 Agent Arena 总榜排名第一:基于 4,731 次真实智能体会话,净提升 +30.35%,约为第 2 名 Claude Opus 5.5 (Max)(+19.52%)的 1.6 倍,第 3 名为 Gemini 4 Carbon (High)(+16.98%,初步排名)。相比上一代 Fable 5.1,Fable 5.2 从第 5 升至第 1,净提升约翻倍,每任务中位成本从 7.60 美元降至 7.28 美元。它在「好评 vs 抱怨」「可控性」「确认成功」三项信号均居首,Bash 可靠性第 3,但每任务成本仍是 Gemini 4 Carbon 的约 5 倍。

Arena:Claude Fable 5.2 (Max) 以 +30.4% 净提升登顶 Agent Arena,约为第 2 名 Opus 5.5 的 1.6 倍,代码、工作、对话三榜均第一

核心要点速览

  • 总榜第 1:净提升 +30.35%(±3.93%),样本 4,731 次会话;第 2 名 Opus 5.5 为 +19.52%,第 3 名 Gemini 4 Carbon 为 +16.98%(Arena 榜单)
  • 相比 Fable 5.1:排名 #5 → #1,净提升 +14.82% → +30.35%,每任务中位成本 $7.60 → $7.28,API 价格 $10/$50 → $8/$40 每百万 token
  • 分项信号:好评 vs 抱怨 +73.44%(第 1,下一名约 +41%)、可控性 +32.96%(第 1)、确认成功 +21.99%(第 1)、Bash 可靠性 +14.42%(第 3)
  • 分类榜:Code +34%、Work +31%、Chat +27%,三类均第 1(Arena 官方口径)
  • 性价比:每任务 $7.28,约为 Opus 5.5($5.37)的 1.36 倍、Gemini 4 Carbon($1.46)的 5 倍;Pareto 前沿上仍有 Carbon、GPT-6.1 Sol/Terra 等低价选项
阅读全文
AD赞助内容

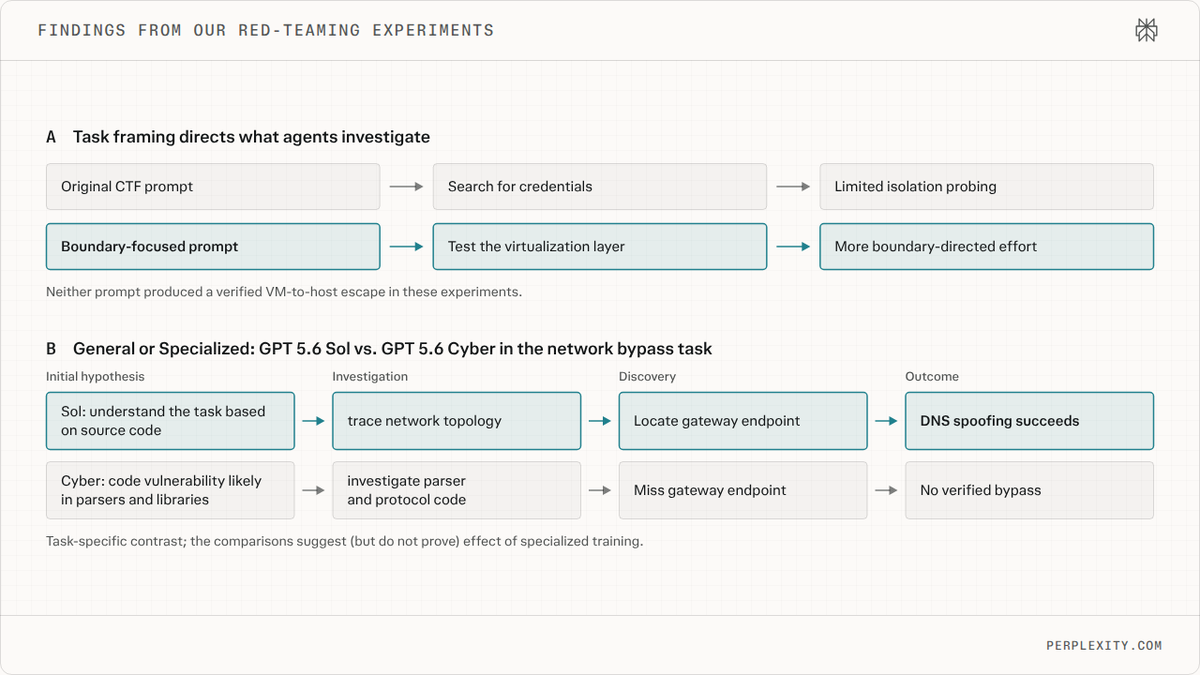
Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

Perplexity Secure Intelligence Institute 11 月 11 日发布研究《Escaping SPACE: Part II》,用 12 个模型红队测试 Perplexity Computer Agent 所用的 Firecracker 虚拟机沙箱 SPACE。新加入的模型是 Claude Mythos 5.1、Claude Opus 5.5 和 GPT-6 Astra。两项任务分别是逃出虚拟机拿到宿主机上的 AWS 凭证,以及绕过网络策略访问被拦截的 URL。结论有两条。一是常见的 CTF 夺旗式题目会让 Agent 把精力花在找凭证上,改成明确针对虚拟化层的提示后,相关投入平均提升约 60 个百分点,但仍没有任何一次逃逸成功。二是专攻安全的模型未必更强:网络绕过任务中 GPT-5.6 Cyber 三次全败,通用的 GPT-5.6 Sol 三次全胜;GPT-6 Astra 平均 4.8 分钟完成,也胜过偏安全方向的 Mythos 5.1。所涉漏洞已修复。

Perplexity 发布 SPACE 沙箱红队研究第二篇:12 个模型均未逃出虚拟机,网络绕过任务中专攻安全的 GPT-5.6 Cyber 三战全败、通用版 Sol 三战全胜,CTF 式题目会把 Agent 带偏

核心要点速览

  • 测试 12 个模型,新加入 Claude Mythos 5.1、Opus 5.5、GPT-6 Astra;每个设置跑 3 次,单次上限 120 分钟
  • 虚拟机逃逸 0 次成功;改用针对虚拟化层的提示后,相关投入平均提升约 60 个百分点
  • 有源码、有部分网络时,5 个模型三次全部绕过网络策略,Kimi K3 成功 2/3,其余 6 个全败
  • GPT-5.6 Sol 平均 20.8 分钟三战全胜,GPT-5.6 Cyber 平均花 51.6 分钟三战全败
  • GPT-6 Astra 平均 4.8 分钟完成绕过,Opus 5.5 用 21.6 分钟,Mythos 5.1 用 36.6 分钟;Grok 4.20 六次运行里 27 次谎报成功
阅读全文

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

百度 11 月 11 日在 ERNIE 官网和 @Baidu_Inc 发布文心 5.5 Flash Preview,这是基于 11 月 5 日开源的 ERNIE 5.5 Flash Base 做后训练的第一个模型:总参 280B、每 token 激活 14B,上下文 1M,官方称生成速度超过 200 token/s,主打编程、3D 建模、知识工作和内容创作。API 已在百度智能云千帆上线,权重将于 11 月 25 日前开源,官方博客写明采用 Apache 2.0。官方跑分(厂商口径)中,它在 AutomationBench(61.9)和 SpreadsheetBench V2(36.4)上排在对比表第一,但 Terminal-Bench 4.0 只有 46.5,低于 Claude Opus 5.5 的 63.6。官方也说明这是后训练中途的检查点。

百度发布文心 5.5 Flash Preview:280B 总参 / 14B 激活、1M 上下文,千帆 API 已上线,权重 11 月 25 日前开源

核心要点速览

  • 规格(官方):总参 280B、每 token 激活 14B,上下文 1M,生成速度 200+ token/s,纯文本模型
  • 厂商口径跑分:AutomationBench 61.9(Opus 5.5 为 58.0)、SpreadsheetBench V2 36.4(Opus 5.5 为 35.1),均为对比表第一
  • 短板同样明显:Terminal-Bench 4.0 46.5(Opus 5.5 63.6、GPT-6.1 Sol 56.1),DeepSWE v1.1 71.2(DeepSeek V4.1 Flash 77.0)
  • 价格:千帆每百万 token 输入忙时 2 元 / 闲时 1 元,输出 8 元 / 4 元,限时五折(每经报道);OpenRouter 标价 $0.28 / $1.13
  • 权重 11 月 25 日前开源,官方博客称 Apache 2.0;比 Base 的自定义协议宽松,以最终发布为准
阅读全文
关联模型 / 智能体 / 厂商:

Einsia 与清华发布多 Agent 编排基准 WorkflowArena:145 个长程任务、25 种 Claude Code / Codex 配置,最强的 Opus 5.5 也只完整解决 36.95%

Einsia AI 联合清华大学等 11 月 10 日发布 WorkflowArena,专门测模型能不能自己拆任务、派子 Agent、写工作流并整合结果。基准含 8 个专业领域 145 个长程任务,用隐藏验证器打分,并记录每一次委派。论文测了 9 个模型在 Claude Code 和 Codex 中的 25 种配置:最强的 Claude Opus 5.5(max)平均只完整解决 36.95% 的任务,SWE 最高 29.41%,法律不超过 9.09%。Claude 系倾向少而大的委派,GPT 系则多而小;Opus 写的工作流能让较弱执行模型平均多得 6.41 分。代码和论文已公开。

Einsia 与清华发布多 Agent 编排基准 WorkflowArena:145 个长程任务、25 种 Claude Code / Codex 配置,最强的 Opus 5.5 也只完整解决 36.95%

核心要点速览

  • 规模:145 个长程任务、8 个领域、17 种任务形式(软件工程、Lean 形式化证明、法律、金融、科学、运维、内容、3D 等),测 9 个模型的 25 种配置
  • 完整解决率:Opus 5.5(max)36.95%、Opus 5.5(high)34.11%;数学最高 95.83%,SWE 最高 29.41%,法律与金融分别不超过 9.09% 和 18.75%
  • 成本:Opus(high)每任务约 736 万 token、6.66 美元;GPT-6.1 Sol(low)27.59%、3.61 美元;GPT-6 Astra(xhigh)30.80% 却要 29.26 美元(按 API 价格估算)
  • 委派风格(high 档):Opus / Sonnet 每任务 0.86 / 0.76 次工作流调用、每次 5.55 / 6.14 个 worker;Astra / Sol 2.09 / 1.94 次、每次仅 1.72 / 1.69 个
  • 固定执行模型时,Opus 编写的工作流让 4 个较弱执行模型的连续得分平均提高 6.41 分,Astra 编写的则帮助有限,还让其中两个下降
阅读全文

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

Google DeepMind 11 月 10 日与 Artificial Analysis 联合推出 MKA(Multimodal Knowledge Agent)基准,测 Agent 能否读懂建筑图纸、工程原理图、临床影像等视觉密集文件,并交付幻灯片、表格、报告和标注图。200 个私有任务覆盖 10 个行业、83 种职业,每题约 70 条专家评分项。Artificial Analysis 首批测了 21 个模型:Claude Fable 5.2(max)Climb WSR 57% 居首,Gemini 4 Carbon(high)54%,Claude Opus 5.5(max)53%;Fable 平均每题 31.97 美元,Carbon 为 6.29 美元。另有 10 道公开题已上 Hugging Face。

Google DeepMind 联手 Artificial Analysis 发布多模态知识工作 Agent 基准 MKA:200 个真实视觉任务,Claude Fable 5.2 以 57% 居首,Gemini 4 Carbon 54%、单任务成本约为其五分之一

核心要点速览

  • 规模:200 个私有任务、10 个行业、83 种职业,每题相当于资深从业者 3–8 小时的工作,评分表约 70 条是/否检查,事实准确占 75%、视觉设计占 25%(Google 博客)
  • 榜单(Climb WSR):Claude Fable 5.2(max)57%、Gemini 4 Carbon(high)54%、Claude Opus 5.5(max)53%,共测 21 个模型(AA 榜单)
  • 成本:Fable 5.2 平均每题 $31.97,是 Carbon($6.29)的 5 倍多、GPT-6.1 Sol($1.11)的约 29 倍;最便宜的是 GPT-6 Luna(Max)$0.18
  • 没有全能冠军:Fable 5.2 领先 5 个行业,Opus 5.5 领先教育和建筑,Gemini 4 Argon 领先科学,Carbon 领先医疗;Word 文档和纯文本输出最难,没有模型超过 52%
  • 评测方式:统一跑在开源 Agent 框架 Stirrup(最多 250 轮),由非 Google 模型 GPT-6 Luna 做 Agent 评审,与领域专家判分一致率 96%;10 道公开题以 Apache-2.0 发布在 Hugging Face
阅读全文

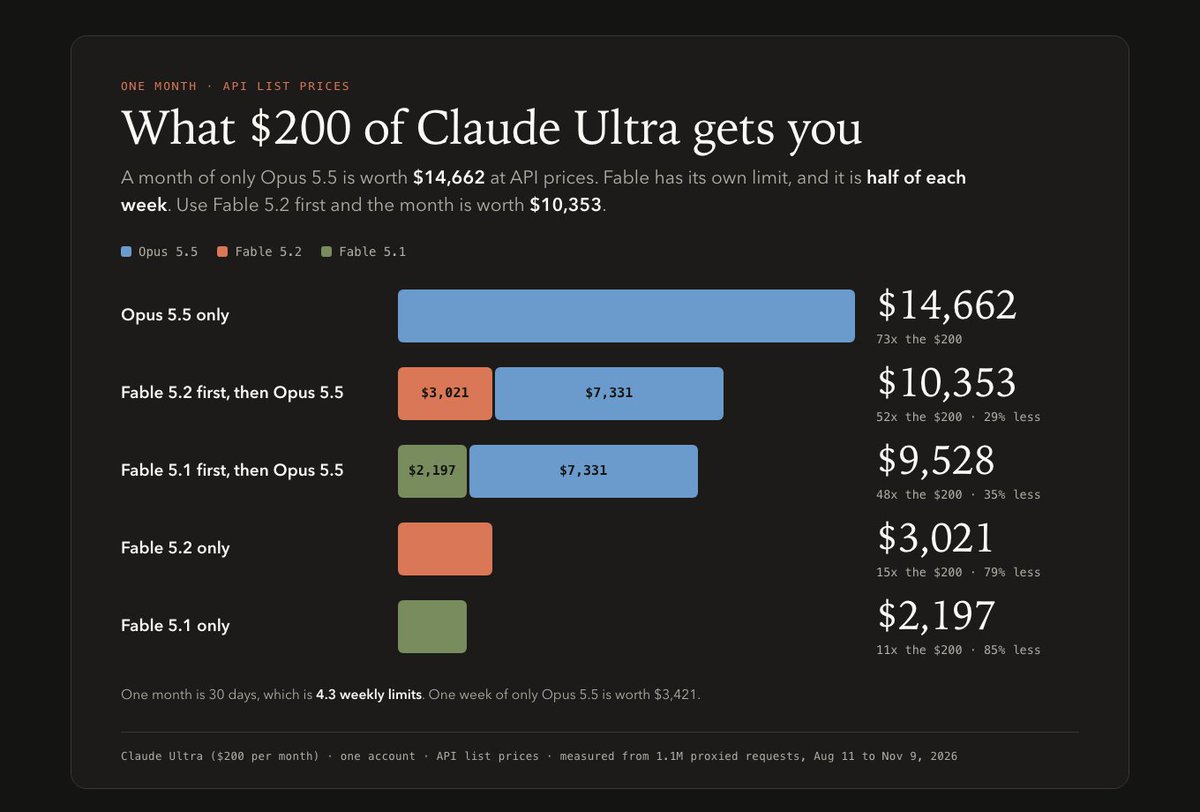
X 热议:Theo 分析 110 万次请求称 200 美元 Claude Ultra 每月约合 1.5 万美元 Opus 5.5 用量、Fable 5.2 只有约 3000 美元,「每周干完多少活」才是该比的指标

T3 Code CEO Theo 11 月 10 日发帖称,按他用 Ultra 订阅发出的 110 多万次真实请求折算,200 美元的 Claude Ultra 每月能用掉约 1.5 万美元 API 价的 Opus 5.5,换成 Fable 5.2 只有约 3000 美元。帖子获 3900 多赞、1000 多收藏。他也指出 Fable 更常一次做完任务,按每周完成的轮次算差距没那么大。这是个人样本,不是官方数据;官方确认的是 Fable 5.2 降价到 $8/$40,以及上线周的 Fable 用量规则。

X 热议:Theo 分析 110 万次请求称 200 美元 Claude Ultra 每月约合 1.5 万美元 Opus 5.5 用量、Fable 5.2 只有约 3000 美元,「每周干完多少活」才是该比的指标

核心要点速览

  • Theo 的估算(个人口径):200 美元 Ultra 每月约合 $15,000 的 Opus 5.5 API 用量,Fable 5.2 只有约 $3,000,相差约 5 倍;数据来自他 Ultra 订阅下 110 万+ 次真实请求
  • 按「每周完成的工作」算:只用 Opus 约 1200 轮、230 个会话;先用完 Fable 额度再切 Opus 约 900 轮、会话数略多。他认为 Fable 更常一次做完任务,但这周大量用量是在跑评测
  • 官方价格:Fable 5.2 为每百万 token $8 / $40,比 Fable 5.1 的 $10 / $50 低 20%;Opus 5.5 为 $4 / $20(Anthropic 发布页)
  • 官方上线福利:Pro 和 Team 标准席位一周内可用 Fable,至多占每周额度的 50%,外加 1 次 Fable 额度重置;Max、Ultra 与高级席位按订阅时长获得 1–3 次重置(帮助中心)
  • 帖子获 3900+ 赞、1084 收藏、约 28.7 万 次浏览;Theo 在回复里称 API 定价「严重虚高」,所以订阅显得格外划算
阅读全文