AI 编程实时动态与要闻

Vercel AI Gateway 上线 Private Inference:自托管、微调和预发布模型用 private/ ID 接入,与目录模型共用 API、鉴权和日志

Vercel 在 X 和官方 changelog 宣布 AI Gateway 支持 Private Inference:企业可把自己的模型端点注册为私有提供商,用 private/<slug> 模型 ID 通过 Chat Completions、Responses 或 Messages 调用,网关自动转换请求格式。私有模型只对本团队可见,凭证加密存储,可按提供商开启零数据保留,并能在 Claude Code、Codex、Cursor 等编程 Agent 中使用,端点故障时可回退到目录模型。
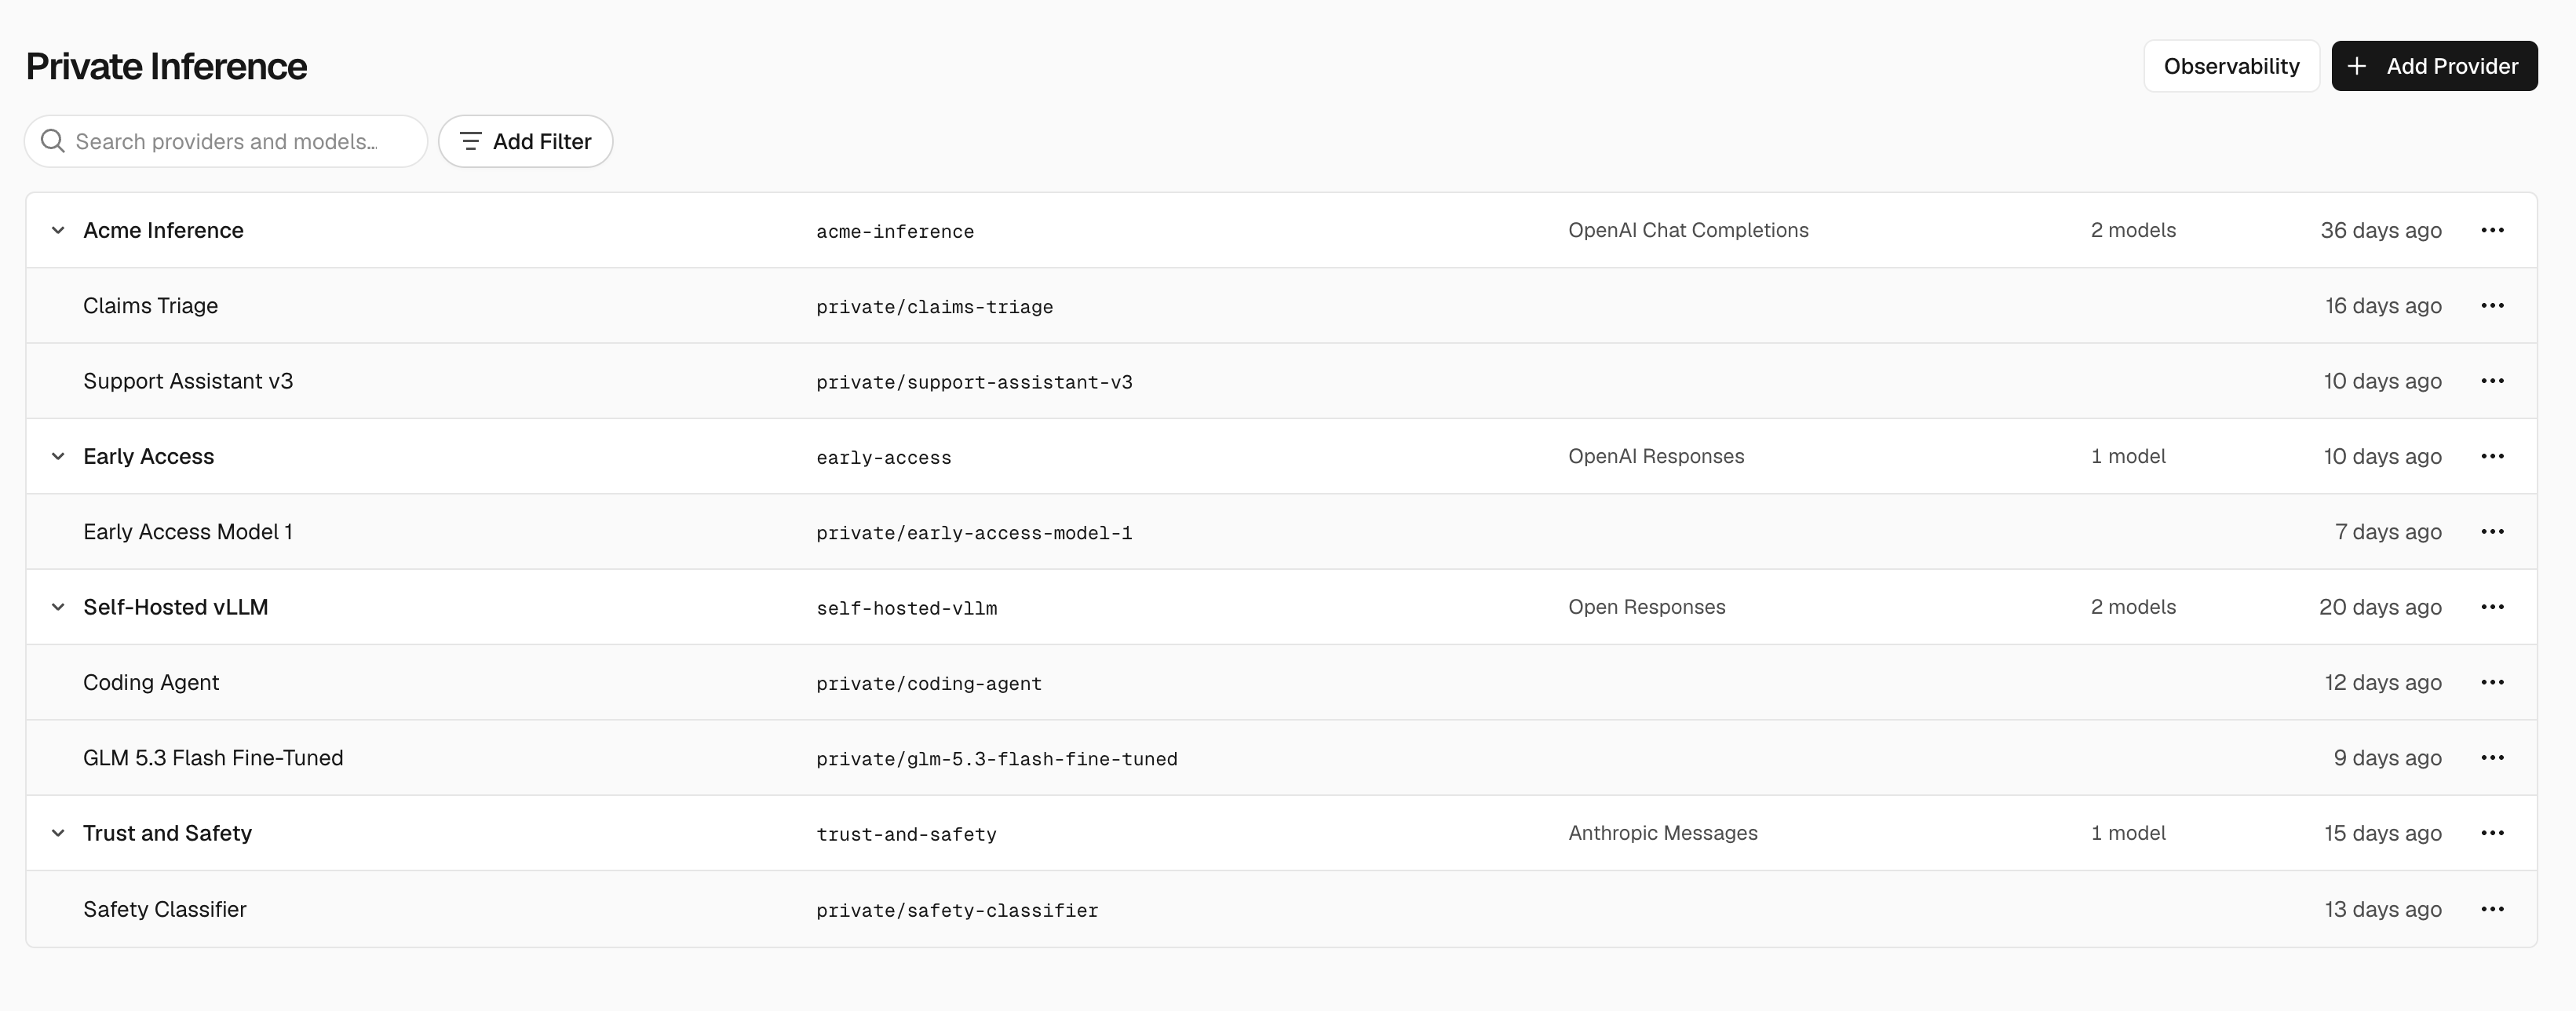
Vercel AI Gateway 上线 Private Inference:自托管、微调和预发布模型用 private/ ID 接入,与目录模型共用 API、鉴权和日志

核心要点速览

  • 把微调、自托管或预发布模型端点注册为私有提供商,用 private/<slug> ID 调用,切换模型只改 model ID
  • 支持 Chat Completions、Responses、Messages 三种 API,网关把请求翻译成端点自身格式
  • 私有模型只对本 Vercel 团队可见、不进公开目录,凭证加密存储,可按提供商开启零数据保留
  • 可在 Claude Code、Codex、Cursor 等接入 AI Gateway 的编程 Agent 里使用;日志、trace drain 和报表与目录模型合并展示
  • 可选端点故障时回退到目录模型;Vercel CLI 65.16.0+ 提供 private-inference providers/models create 命令
阅读全文

Traces 加入 Vercel:AI 编程 Agent 会话共享平台,已接入 16 种编程 Agent、累计近 50 万次会话,暂停新建组织

Traces 创始人 Tarun Sachdeva 在 X 和官方博客宣布 Traces 加入 Vercel,整个团队将在 Vercel 继续做“团队如何用 Agent 构建软件”。Traces 今年 2 月上线,是记录和分享 AI 编程 Agent 会话的 CLI 与平台,九个月内做了团队版、16 种编程 Agent 适配器、Git 集成、Handoffs、Traces MCP 等,数千个团队共享了近 50 万次会话。现有用户第一天不受影响,但已暂停新建组织;交易条款官方未公布。

Traces 加入 Vercel:AI 编程 Agent 会话共享平台,已接入 16 种编程 Agent、累计近 50 万次会话,暂停新建组织

核心要点速览

  • Traces 是记录、分享 AI 编程 Agent 会话的 CLI 与平台,今年 2 月上线,整个团队加入 Vercel
  • 九个月内上线团队版、16 种编程 Agent 适配器、Git 集成、Handoffs、Traces MCP 和 Surfaces
  • 数千个团队加入,共享了近 50 万次会话
  • 现有用户可继续分享会话、使用 CLI、往已有组织加人,但已暂停新建组织;收购金额等条款官方未公布
  • Vercel 创始人兼 CEO Guillermo Rauch 在 X 上称 Traces 是软件开发的新基础单元,记录意图、提示、推理、技能和工具调用
阅读全文

Vercel Token Pass 加量不加价:每团队每月 $30 现含 $150 开源模型 token(原 $80),覆盖 Kimi K3/K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash

Vercel 于 2026-11-13 在官方 changelog 宣布:Token Pass 每月包含的 token 额度从 $80 提高到 $150,价格仍是每团队每月 $30。额度只用于 AI Gateway 上的精选开源权重模型,包括 Kimi K3、Kimi K3.1 Pro、GLM 5.3、GLM 5.3 Flash 和 DeepSeek V4.1 Flash;每个计费周期重置、不结转。Token Pass 仍是 Pro 团队的 Early Access 附加项,名额有限。

核心要点速览

  • 价格不变、额度提升:$30/团队/月,月度 token 额度从 $80 提高到 $150,约为价格的 5 倍
  • 适用模型:AI Gateway 上的精选开源权重模型,包括 Kimi K3、Kimi K3.1 Pro、GLM 5.3、GLM 5.3 Flash、DeepSeek V4.1 Flash;闭源模型不在其中
  • 额度用完后:用标准 AI Gateway key 或 OIDC token 的请求回落到团队 AI Gateway 余额;用 Token Pass 专属 key 的请求直接停止,不产生超额费用
  • 额度每个计费周期重置,不结转;Token Pass 是 Pro 团队的 Early Access 附加项,名额满后需排队
  • 接入方式:在 Vercel CLI 运行 vercel token-pass 连接编码 Agent,或在支持 AI Gateway 的 Agent 中使用 Token Pass API key
阅读全文

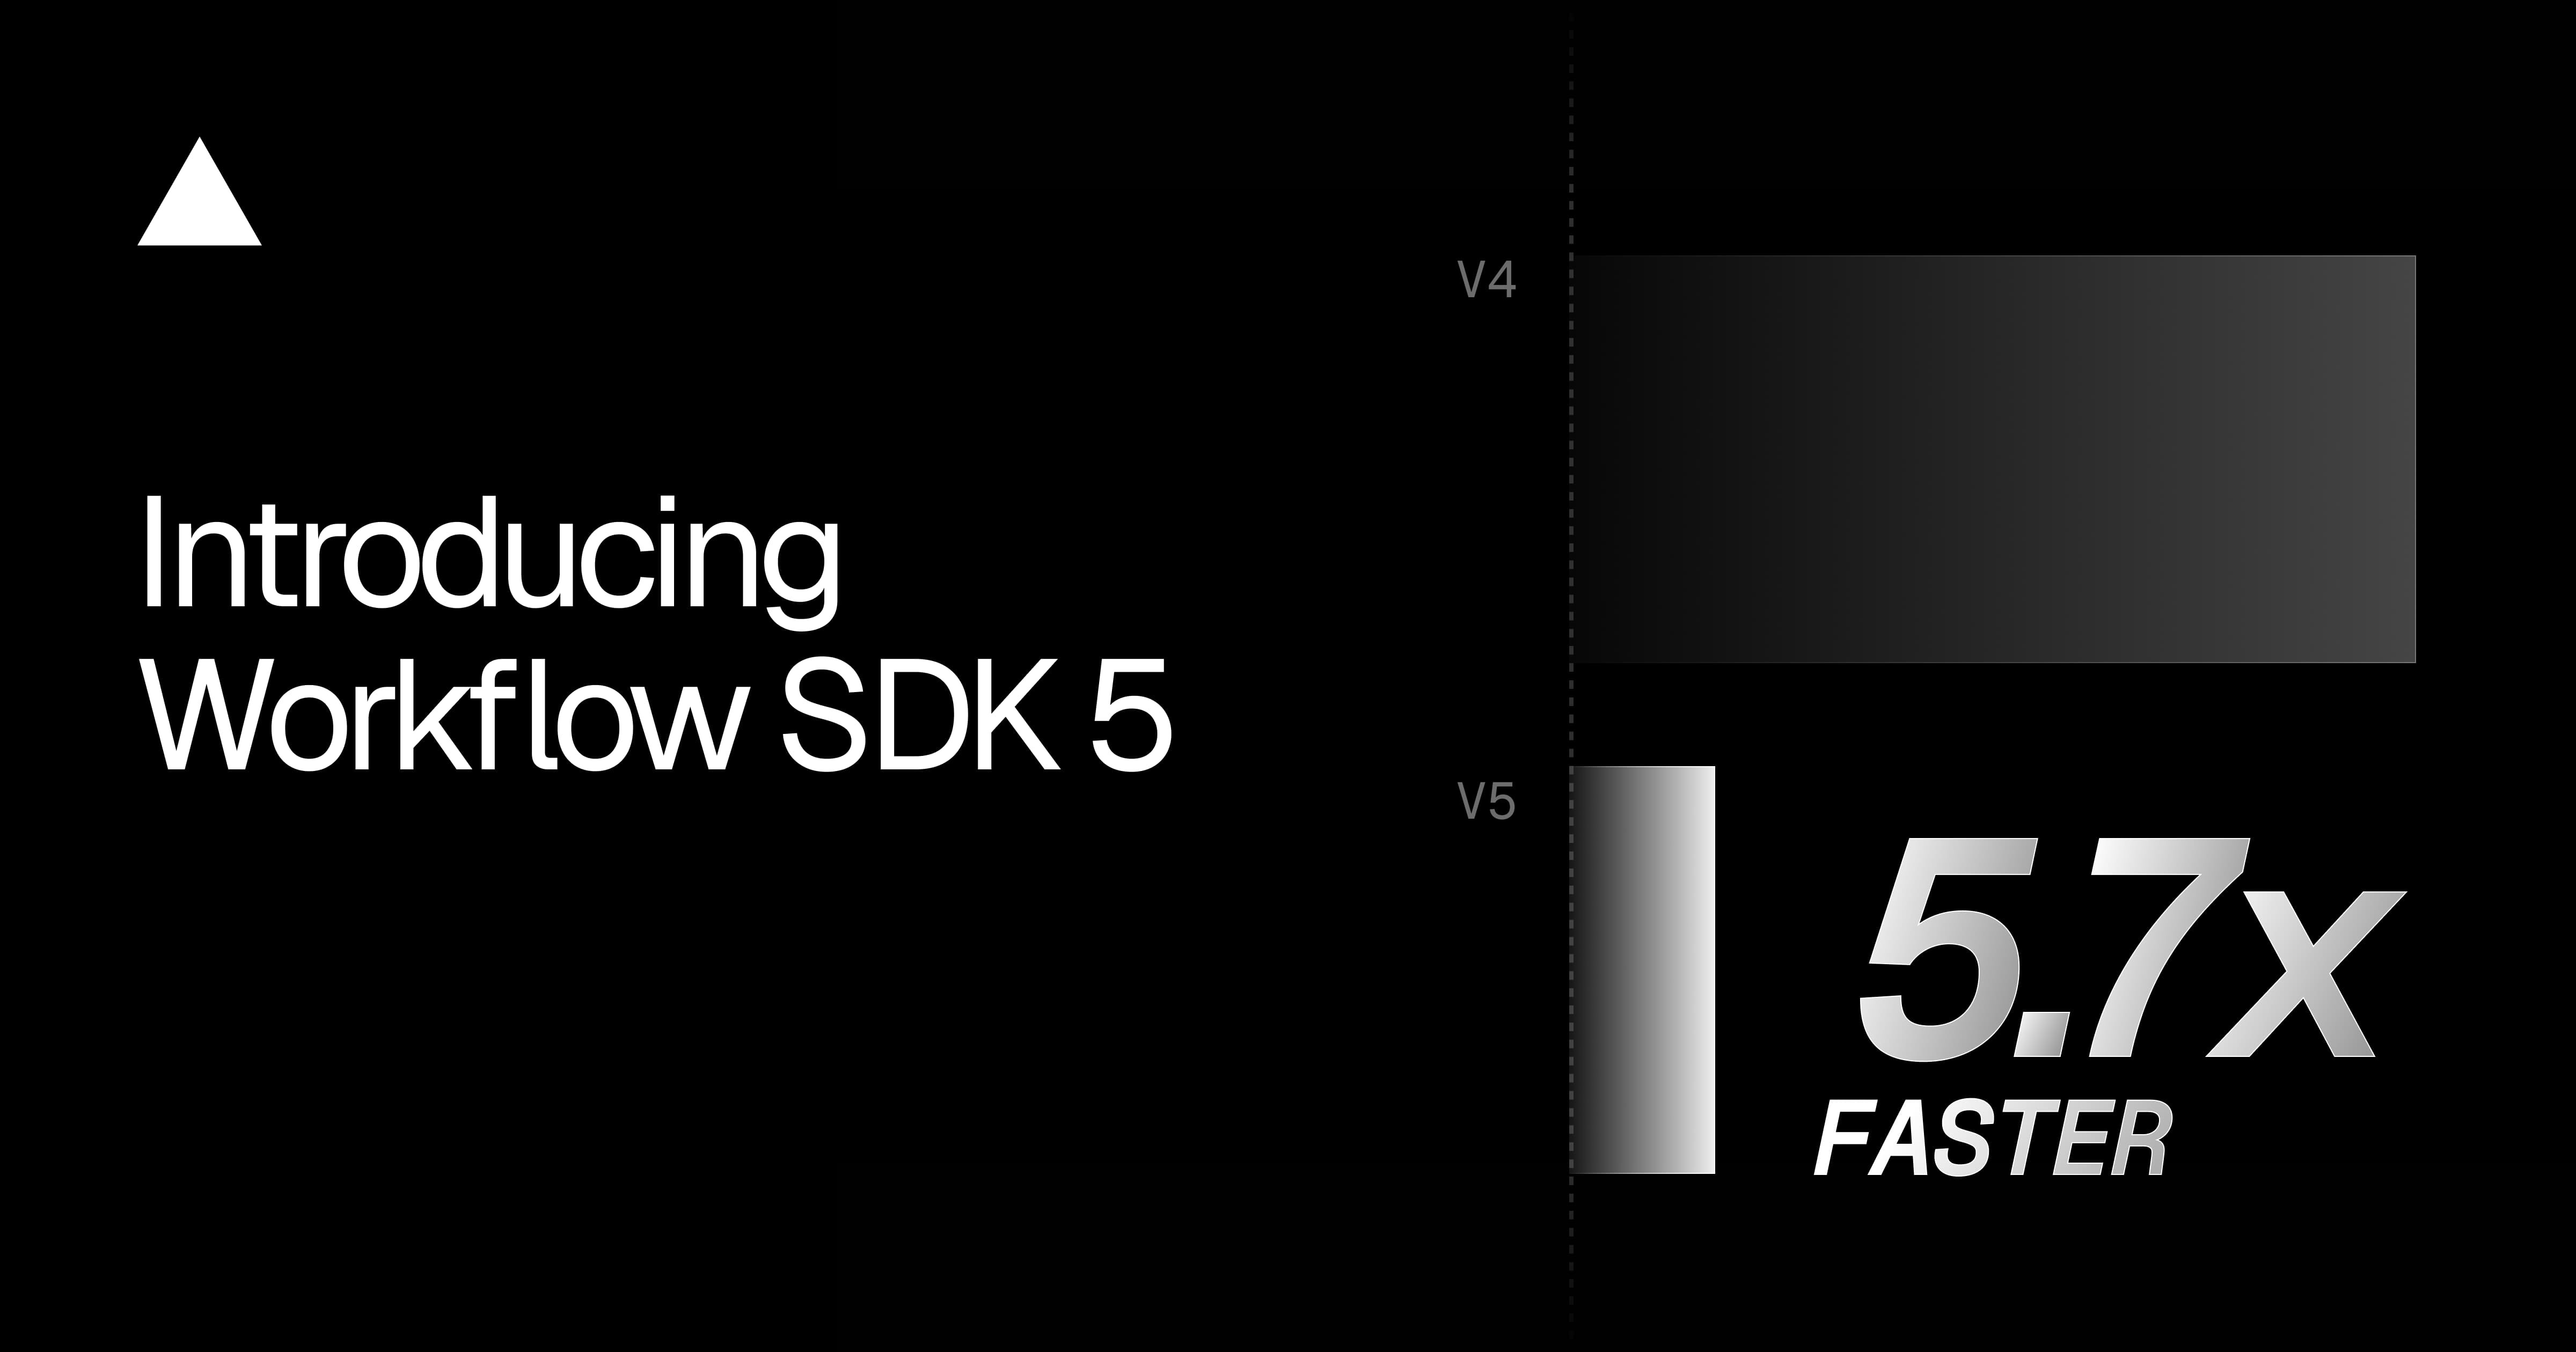
Vercel 发布 Workflow SDK 5:为智能体循环重写持久化引擎,步骤间开销最多降 25 倍,所有负载默认端到端加密,运行可按区域就近存放

Vercel 发布 Workflow SDK 5。官方称上线以来已跑过 40 亿步、7 亿次运行,新版重写引擎减少队列往返,1,020 步任务中位耗时从 21 分钟降到 3 分钟;步骤输入输出用每次运行独立密钥的 AES-256-GCM 加密;工作流基础设施部署到所有 Vercel 函数区域,并支持 Pi、OpenCode 等智能体框架做持久化。

Vercel 发布 Workflow SDK 5:为智能体循环重写持久化引擎,步骤间开销最多降 25 倍,所有负载默认端到端加密,运行可按区域就近存放

核心要点速览

  • 官方基准(v5.2.0 对比 v4.8.12):首步 p75 从 418 毫秒降到 172 毫秒,步骤间 p75 从 618 毫秒降到 109 毫秒,长任务后段开销从 1,748 毫秒降到 70 毫秒(25 倍)
  • 流式输出默认走 WebSocket:回放一段 52.4 秒的智能体回复,中位送达时间从 226.1 秒降到 53.5 秒,token 流压缩后平均小约 80%
  • 负载端到端加密:每次运行独立密钥,Vercel 只存密文,解密在浏览器或终端完成并记入审计日志;可设保留期为 0,运行结束即删数据
  • 运行状态存放在发起请求的区域,也可用 region 参数指定(如法兰克福),单区故障不影响其他区域的新运行
  • durable-harness 可给 Pi、OpenCode 加持久化,Claude Code 和 Codex 在 Vercel Sandbox 中为实验性集成;Python SDK 进入测试版
阅读全文
AD赞助内容

Vercel 发布 UI SDK 测试版:把弹层、选择、键盘导航等拆成 50 多个「行为」交给 AI 智能体组装组件,支持 React、Vue、Svelte、Solid 和 Web Components,Apache 2.0 开源

新加坡时间 11 月 13 日 02:41,Vercel 官方账号发帖推出 UI SDK。它不是又一套组件库,而是把界面交互拆成可复用的「行为」:弹层定位与关闭、单选多选、输入跳转、焦点管理、拖拽排序、虚拟列表等,官方称已做了 50 多个。开发者不用自己学这些 API,而是给编程智能体装上 UI SDK 技能,由智能体按需求挑选行为、拼成新组件,并输出到 React、Vue、Svelte、Solid 或 Web Components。代码在 GitHub vercel-labs/ui,Apache 2.0 许可,npm 包 @ui-sdk/core 当前为 0.1.0-beta.1,API 仍可能变动。

Vercel 发布 UI SDK 测试版:把弹层、选择、键盘导航等拆成 50 多个「行为」交给 AI 智能体组装组件,支持 React、Vue、Svelte、Solid 和 Web Components,Apache 2.0 开源

核心要点速览

  • 官方称已构建 50 多个行为,如 createPopup、createSelection、createTypeahead、createRovingFocus、createVirtualizer
  • 同一套行为可渲染到 5 种前端:React(需 19 及以上)、Vue、Svelte、Solid、Web Components
  • 一条命令给智能体装技能:npx skills add vercel-labs/ui --skill ui-sdk
  • 官方口径:智能体直接读取页面并操作控件、不依赖截图,速度提升一倍以上、成本不到一半(未公布测试方法)
  • Apache 2.0 开源,npm @ui-sdk/core 于 11 月 13 日 01:12(新加坡时间)发布 0.1.0-beta.1
阅读全文
关联模型 / 智能体 / 厂商:

Gemini API Managed Agents 支持自托管环境:Agent 的 shell 和文件工具可跑在你自己的沙箱里,只需出站 HTTPS,官方给出 Cloud Run、Cloudflare、Daytona、E2B、Modal、Vercel 等 8 种接入示例

Google AI Studio 11 月 11 日(北京时间 12 日凌晨)宣布,Gemini API 的 Managed Agents 现在可以“自带沙箱”。以前 Antigravity 等托管 Agent 的工具只能在 Google 托管的 Linux 沙箱里执行;现在 Agent 循环和模型调用仍在 Google 一侧,执行 shell 命令、读写文件这些工具调用则可以交给你自己的容器、VM 或 microVM。接入方式是先调用 POST /v1beta/environments 并传 {"mode":"self_hosted"},拿到环境 id 和只返回一次的 environment_key,再在沙箱里运行开源 gemini-api CLI 的 environments connect。全程只走出站 HTTPS,不需要开放入站端口。

Gemini API Managed Agents 支持自托管环境:Agent 的 shell 和文件工具可跑在你自己的沙箱里,只需出站 HTTPS,官方给出 Cloud Run、Cloudflare、Daytona、E2B、Modal、Vercel 等 8 种接入示例

核心要点速览

  • 分工:Agent 循环、模型和交互流留在 Google,7 个内置工具(execute_bash、读写/编辑文件、list_dir、grep_search、find_by_name)在你的环境执行
  • 网络:100% 出站 HTTPS,无需开放入站端口;worker 只持有环境级 environment_key,项目级 GEMINI_API_KEY 不用放进沙箱
  • 两种模式:environments connect 单 worker 长驻;environments poll + serve 为每次交互起一个新沙箱,沙箱里只有短期 lease token、零 API key
  • 官方示例覆盖 8 家:Cloud Run、Agent Substrate、Cloudflare Sandbox、Daytona、E2B、Fly.io、Modal、Vercel Sandbox,另有 Docker / rootless Podman 配方
  • 限制:sources、network、env 和 /files 快照只适用于 Google 托管环境,自托管环境传这些会返回 400 INVALID_ARGUMENT;单独定价官方未公布
阅读全文

Vercel AI Gateway 上线 DeepSeek V4.1 Flash 1017 Ultrafast:厂商口径逾 1000 tokens/s,经 Fireworks 加速端点公测

Vercel 于 2026-11-07 发布更新日志(作者 Jerilyn Zheng、Zachary Chen),宣布 DeepSeek V4.1 Flash 1017 Ultrafast 经 Fireworks 加速无服务器端点接入 AI Gateway;官方开发者账号 @vercel_dev 在 17:25 UTC 发帖。厂商口径称生成速度逾 1000 tokens/s,服务的是 2026-10-17 的 V4.1 Flash 更新,而非新的基础模型权重。型号页列出上下文窗口 1,048,576 Token,定价为输入 $2.40 / 百万 Token、输出 $9.60 / 百万 Token;公开预览无 waitroom、无会话时限。型号 ID 为 deepseek/deepseek-v4.1-flash-1017-ultrafast,可通过 AI SDK、OpenAI 兼容接口,以及 Claude Code / Codex / Cursor 的 npx vercel ai-gateway setup 调用。

Vercel AI Gateway 上线 DeepSeek V4.1 Flash 1017 Ultrafast:厂商口径逾 1000 tokens/s,经 Fireworks 加速端点公测

核心要点速览

  • 发布:Vercel 更新日志日期为 2026-11-07,作者 Jerilyn Zheng、Zachary Chen;@vercel_dev 于 17:25 UTC 发帖,抓取时约 909 赞、390 收藏、约 9.8 万次展示
  • 型号:deepseek/deepseek-v4.1-flash-1017-ultrafast,服务 2026-10-17 的 V4.1 Flash 更新,走 Fireworks 加速无服务器端点,不是新的基础模型权重
  • 速度(厂商口径):逾 1000 tokens/s;型号页列出上下文窗口和最大输出均为 1,048,576 Token;公开预览无 waitroom、无会话时限
  • 定价(Vercel 型号页):输入 $2.40 / 百万 Token,输出 $9.60 / 百万 Token;更新日志称 AI Gateway 按提供商价格、不加价,BYOK 推理也不收平台费
  • 接入:AI SDK 或 base_url https://ai-gateway.vercel.sh/v1;Claude Code / Codex / Cursor 可用 npx vercel ai-gateway setup;fx 可用 /model deepseek/deepseek-v4.1-flash-1017-ultrafast
阅读全文

Mitchell Hashimoto 发布 libghostty-vt 1.0:稳定 C ABI 终端仿真库,已服务 JetBrains 等数千万用户与 Agent 工具

Ghostty 作者 Mitchell Hashimoto 于 2026-11-06 宣布 libghostty-vt 1.0:从 Ghostty 抽出的可移植 C 终端仿真库,ABI 按语义化版本稳定,邀请发行版正式打包。官方称已在数百个项目中运行,覆盖 JetBrains IDE 终端(约 1250 万活跃用户)、Vercel Turborepo TUI、以及 herdr / cmux 等 Agent 编码工具;并曾在 4 核 8GB 机器上同时跑约 1 万个活跃终端。文档明确用途含「读取 TUI 画面的 Agent 与自动化」。

Mitchell Hashimoto 发布 libghostty-vt 1.0:稳定 C ABI 终端仿真库,已服务 JetBrains 等数千万用户与 Agent 工具

核心要点速览

  • 形态:libghostty-vt 1.0,MIT,零业务依赖(默认可链 libc;可 freestanding)
  • 稳定:语义化版本 + 严格 ABI;opaque handle + enum getter/setter;ELF 符号版本;CI 用 libabigail 卡基线
  • 落地:JetBrains 全线 IDE 终端已换用(约 1250 万活跃用户);Neovim 替换 libvterm 的 PR 已批准待打包;herdr / cmux 等 Agent 工具直接建在其上
  • 性能口径(官方):4 核 8GB 可跑约 1 万活跃带 shell 终端;WASM 全功能体积可压到约 1MB 以下
  • Agent 意义:文档写明可用于「读取 TUI 显示内容的 Agent/自动化」,避免每个编码 Agent 自研 VT 解析
阅读全文

Vercel Token Pass 额度自动走 AI Gateway:标准 API Key / OIDC / fx 即可扣减,用尽可回落团队额度

2026-11-06,Vercel 更新 Token Pass:featured 模型用量经 AI Gateway 时,标准 API Key、OIDC 或 fx 登录即可自动扣减 Token Pass 额度,不必再用专用 key;额度用尽后标准认证回落到团队 AI Gateway 额度,专用 Token Pass key 仍停到下账期。

Vercel Token Pass 额度自动走 AI Gateway:标准 API Key / OIDC / fx 即可扣减,用尽可回落团队额度

核心要点速览

  • 官方:Vercel changelog 2026-11-06「Token Pass credit now applies automatically across AI Gateway」
  • 行为:标准 API Key / OIDC / fx 登录均可先扣 Token Pass 额度,无需专用 key
  • 回落:额度用尽后标准 key/OIDC 用团队 AI Gateway 额度;专用 Token Pass key 仍停到下账期
  • 产品口径:Pro 约 $30/月 → ~$80 featured 开源模型额度;路径保持 ZDR
  • 建议:早期专用 key 用户改用标准 key/OIDC 以启用回落
阅读全文

Vercel Schedules 公测:静态/动态定时任务可在运行时创建,面向 Agent 与 Queue,全计划可用

2026-11-05,Vercel 宣布 Schedules 公测(全计划):可在 vercel.json 定义静态调度,或经 SDK/CLI/API 动态创建一次性与 cron 任务,投递到私有 Function、HTTP 或 Queue;Eve 与 AI SDK 可据此给 Agent 做「明早再做」工具。旧 Cron Jobs 仍可用。

Vercel Schedules 公测:静态/动态定时任务可在运行时创建,面向 Agent 与 Queue,全计划可用

核心要点速览

  • 官方:Vercel 2026-11-05 changelog + 博客 Introducing Vercel Schedules;X @vercel 同步
  • 能力:静态(vercel.json)与动态(SDK/CLI/API)一次性/cron;目标 Function / HTTP / Queue
  • Agent:Eve 内建动态调度;AI SDK 示例用 Schedules.create + Queue 唤醒
  • 计费(厂商):Pro/Ent 约 $5/1M runs、$10/1M creations;Hobby 500 创建 / 5,000 runs/月
  • 旧 Cron Jobs 可继续;schedule/v1beta 函数无公网 URL
阅读全文
AD赞助内容

X 热议:Vercel CEO Guillermo Rauch 称「AI 会把人类写的软件全部重写很多遍」,引发关于形式化验证与重写风险的争论

11 月 5 日 Rauch 在 X 发帖称,大多数人写的软件又慢、漏洞多、规格不清,AI 会把它们重写很多遍,并做形式化验证、压测和加固,「这才是软件工程真正的诞生」。帖子约 3,000+ 赞、270+ 转发、近 10 万浏览;赞同者举出用 AI 从零重写的案例,反对者提醒规格缺失和人工复核的问题。这是个人观点,不是 Vercel 官方公告。

核心要点速览

  • Rauch 原帖(11-05 02:22 UTC)约 3,060 赞、272 转发、681 收藏、约 9.9 万浏览(抓取时数据)
  • 核心观点:AI 会重写人类软件「很多遍」,并做形式化验证、压测、加固,把内存不安全的底层换成更稳的实现
  • 前一小时他还转发 Vercel Security Review 数据:24 小时发现 6,817 个漏洞、580 个严重/高危、Agent 已修 1,411 个(厂商口径)
  • 反方声音:重写缺规格的代码只会更快复制错误行为,形式化验证也不会让 bug 消失,只是上移到更高抽象层
  • 这是观点讨论,不是事实或官方路线图
阅读全文
关联模型 / 智能体 / 厂商:

Vercel Security Review 公测:每次 GitHub push 自动做漏洞审查,Vercel Agent 一键修复

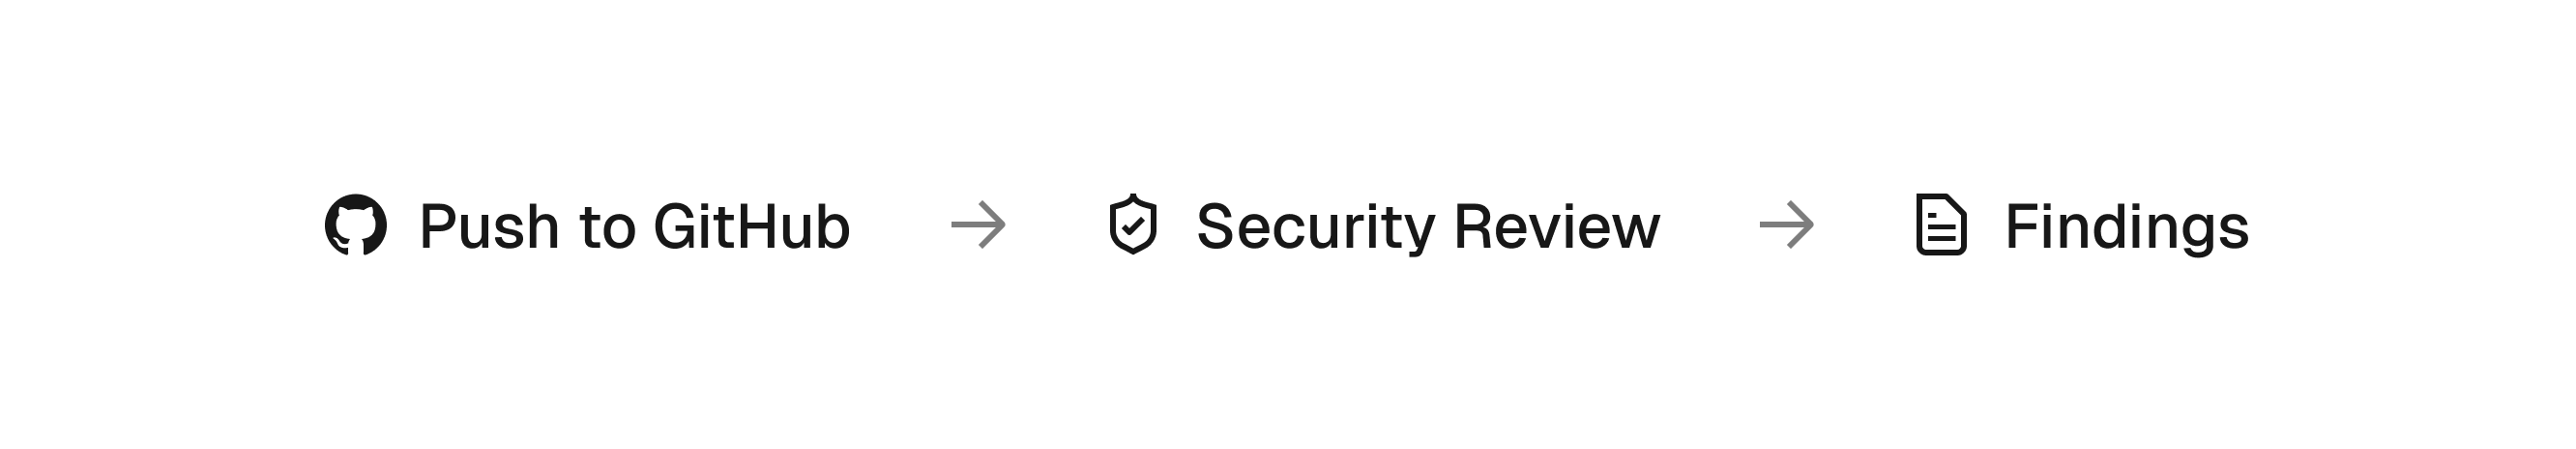
Vercel 于 11 月 3 日(美西时间)宣布 Security Review 公测。它是 Vercel Agent 的新能力,与 Code Review、Investigation 并列:开启后,团队关联的 GitHub 仓库每次 push 都会只针对改动的 diff 做漏洞审查,几秒内完成;发现的问题进入 Security 仪表盘、PR 评论和 CLI,可一键交给 Vercel Agent 修复,或用 vercel security vulnerabilities 拉给自己的编码 Agent。面向 Pro 与 Enterprise,11 月 10 日前审查免费。

Vercel Security Review 公测:每次 GitHub push 自动做漏洞审查,Vercel Agent 一键修复

核心要点速览

  • 触发方式:每次 GitHub push(含直接推生产分支)自动审查,只扫改动 diff,官方称“几秒内完成”,可覆盖每个 preview 与 production 部署
  • 不止模式匹配:Agent 会追踪改动代码的可达路径、检查已有防护并复核每条发现,官方举例可抓到“缺少授权校验”这类逻辑漏洞
  • 团队可用自然语言写安全策略,按项目或全团队生效,也可用 vercel security policy 管理
  • 计费:按 Vercel Agent 费率,模型 token 按供应商原价不加价,另加每百万 token 0.25 美元;审查在 2026 年 11 月 10 日前免费,Agent 修复照常计费
  • 可用范围:Pro 与 Enterprise 团队公测;官方未公布检出率或误报率等跑分
阅读全文

X 热议:Vercel CEO Guillermo Rauch 喊话「拥有你自己的智能」,呼吁本地模型继续普及、自己掌握 Agent 的 harness 与数据

Vercel CEO Guillermo Rauch 11 月 1 日在 X 上发帖:「拥有你自己的智能。任何反对这一点的人都有东西要卖给你(也许是把你自己的智能再卖回给你)。」他认为本地模型需要继续普及,超大模型暂时跑不了本地,所以最好的选择是保持选择权:自己掌握 harness、数据、连接和运行时,也就是自己的 Agent,并拥抱开源。帖子约 12 小时内获得约 2500 赞、12.8 万浏览,100 多条引用,讨论集中在本地与云端如何取舍。

核心要点速览

  • 这是 Rauch 的个人观点帖,不是 Vercel 官方公告或产品发布。
  • 原帖(2026-11-01 21:08 UTC)约 2533 赞、255 转发、266 回复、107 引用、12.8 万浏览,581 次收藏(抓取时数据)。
  • 核心主张:本地模型要继续普及;在超大模型跑不了本地之前,保持选择权,自己掌握 harness、数据、连接、运行时和 Agent,拥抱开源。
  • Maple AI 联合创始人兼 CEO Mark(@marksuman)引用回应:会是混合形态,云端永远更强,未来要把本地优先的 AI 和私有云配合起来。
  • 工程师 Shantanu Goel(@shantanugoel)引用称「Guillermo 说出了多数人不愿说的真话」,约 37 赞。
阅读全文
关联模型 / 智能体 / 厂商:

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

10 月 31 日,Vercel Labs 的 Chris Tate(agent-browser 作者)在 X 上发布 agent-desktop,称其为「整台电脑版的 agent-browser」。它是一个 Rust 编写、Apache-2.0 开源的 CLI 和 C 库:读取桌面应用的系统无障碍树,以 JSON 返回每个可操作元素的 ref,Agent 按 ref 点击、输入后再快照核对,不做像素匹配,默认在后台无头运行。1.0.0 已于 10 月 27 日发布并首次加入 Linux 支持,目前 npm 最新版为 1.0.2。

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

核心要点速览

  • 安装:npm install -g agent-desktop,一个包自带 x64/ARM64 原生二进制;1.0.0(10-27)加入 Linux(glibc 2.35+,经 AT-SPI),npm 最新 1.0.2(10-30)
  • 工作方式:snapshot 输出带 ref 的 JSON 树,click @<snapshot_id>:eN 操作,再 snapshot 核对;UI 变化时返回 STALE_REF,错误里带 retry 是否安全的标记
  • 规模:README 称共 60 个命令名、56 个可用命令,覆盖窗口、键鼠、通知、剪贴板、等待与会话追踪
  • 默认无头:按 ref 的操作走无障碍 API,不移动鼠标、不抢焦点,需要真实输入时加 --headed;Chris Tate 称多个 Agent 可各带一个光标并行使用电脑
  • 跑分:官方未公布任何成功率或速度基准;它只是工具,不内置模型,网页自动化仍交给 agent-browser
阅读全文

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文